메타정보
| 항목 | 내용 |
| 저자 | Zhendong Mi, Shaoyi Huang (Stevens Institute of Technology · 미국) |
| 학회 | arXiv · 2026 · CC BY 4.0 |
| arXiv 또는 DOI | 2609.12317 |
| 데이터 | MATH500 · HumanEval · GPQA-Diamond · AlpacaEval 2.0 |
| 리뷰 일자 | 2026-09-15 |
TL;DR
- DF-Sample은 여러 추론 경로를 트리로 생성하고, 말단의 평가를 부모 노드로 전달한 뒤 생성 확률과 효용을 함께 반영해 경로를 뽑음.
- Qwen2.5-Math-7B에서 MATH500 81.8%, GPQA-Diamond 45.6%를 기록함.
- 각각 GRPO보다 3.3%p, 5.7%p 높지만 모든 모델·벤치마크에서 최고인 것은 아님.
- 학습이 없다는 말과 외부 평가기가 없다는 말은 다름.
- 구현은 GPT-4o로 말단 품질을 평가하며, 비교한 Power Sampling은 자체 likelihood를 사용하는 방법임.
- MATH500의 문제당 시간은 약 384초로 Power Sampling의 약 340초 대비 약 44초 증가.
- 최종 답변이 약 620토큰이라는 사실은 트리 전체의 생성량이 적다는 뜻이 아님.
- 이 결과는 후보 생성과 선택을 개선할 여지가 있음을 보여줌.
- RL의 역할 전체가 분포를 뾰족하게 만드는 데 한정된다거나, 탐색만으로 항상 RL을 대체할 수 있다는 증거로 읽기는 어려움.
소개 (Introduction)
- 후보 생성과 정답 선택의 간극.
- 언어모델의 오답을 모두 지식 부족으로 설명하기는 어려움.
- 가능한 풀이를 여러 개 만들어 보면 그중에는 정답이 있는데, 평소의 생성 방식으로는 그 풀이가 잘 나오지 않는 경우가 있음.
- 예를 들어 방정식 $x^2=5x$에서 양변을 $x$로 나누는 길은 짧고 익숙하지만, 그 순간 $x=0$이라는 해를 잃음.
- 반대로 인수분해를 택하면 두 해를 모두 얻음.
- 논문의 Figure 2는 이 차이를 이용해 생성 확률이 높은 풀이와 올바른 풀이가 반드시 일치하지 않음을 설명함.
- 그림의 확률은 개념을 보여주는 예시이며 실제 벤치마크 측정값으로 취급하면 안 됨.
- Reinforcement learning (강화학습, RL)의 역할.
- RL은 모델에게 새로운 추론 방법을 가르치는가, 아니면 이미 만들 수 있던 좋은 답변을 더 자주 선택하게 하는가?
- 두 효과는 함께 존재할 수도 있지만, 후자의 비중이 크다면 추론 시점의 sampling을 바꾸는 것만으로도 성능을 높일 여지가 있음.
- 다만 좋은 경로가 분포 어딘가에 존재한다는 사실과, 한정된 계산 예산 안에서 그 경로를 찾아낼 수 있다는 사실은 별개의 문제임.
- 특히 초반에 그럴듯했던 선택이 마지막 결론을 망치는 문제에서는 다음 한 단계의 확률만 보고 판단하기 어려움.
- 후속 결과를 이용한 분기 선택.
- Mi와 Huang의 Sampling via Decision-Flow가 다루는 핵심 문제.
- 후보들을 일정 깊이까지 먼저 확장하고, 끝에 도달한 결과를 평가한 다음, 그 정보를 앞쪽의 분기 결정에 돌려줌.
- 핵심은 단순히 답을 많이 생성하는 데 있지 않음.
- 앞으로 어떤 결론에 도달하는지가 현재 선택의 가치를 결정하도록 만듦.
- 결과를 해석할 때는 실험이 뒷받침하는 주장과 추가 검증이 필요한 가설의 구분이 필요함.
- 특히 생성 모델, 검색 절차, GPT-4o 평가기를 하나의 시스템으로 보아야 결과를 정확하게 읽을 수 있음.
핵심 기여 (Key Contributions)
- 추론 트리에 terminal utility를 결합함.
- 마지막 추론 단계의 likelihood와 품질 점수를 에너지로 바꾸고, 낮은 에너지를 높은 효용으로 변환함.
- 다음 단계의 자연스러움에 최종 결과의 정보를 더하는 설계임.
- 효용을 이용해 중간 분기의 선택 확률을 바꿈.
- 부모의 효용은 자식 효용의 prior 가중평균이며, 실제 선택은 prior와 효용의 곱에 비례함.
- 여기서 backward propagation은 신경망 학습을 위한 gradient 계산이 아님.
- 블록 단위 탐색으로 깊이에 따른 비용을 제한함.
- 전체 풀이를 한 번에 완전한 트리로 만들기 어려우므로 일정 길이의 부분 경로를 고르고 이어 나감.
- 대신 미래를 평가하는 범위도 블록 안으로 제한됨.
- 수학·코드·과학·일반 지시 수행에서 결과를 보고함.
- 세 모델의 네 벤치마크, 분기 수와 에너지 계수의 ablation, Pass@k와 출력 분포 분석을 함께 제공함.
- 성능 개선의 범위와 예외를 함께 볼 수 있다는 점이 유용함.
관련 연구 / 배경 지식
Distribution sharpening과 Pass@k
- Distribution sharpening은 좋은 결과 주변으로 확률 질량을 집중시키는 관점임.
- 정답 경로가 원래도 존재했지만 드물게 나왔다면, 그 경로를 더 자주 내놓도록 바꾸어 한 번의 시도에서 성공할 확률을 높일 수 있음.
- 이때 모델이 해결할 수 있는 문제의 전체 범위까지 반드시 넓어지는 것은 아님.
- 같은 답변 양식에 확률이 몰리면 여러 번 시도해도 비슷한 실패를 반복할 수 있음.
- 논문은 이런 가능성을 배경으로 삼지만, 모든 RL 방법이 동일한 방식으로 작동한다는 정리까지 제시하지는 않음.
- Pass@k는 한 문제에 대해 k개의 답변 후보 중 하나라도 정답이 있는지를 보는 지표임.
- Pass@1이 높으면 적은 시도에서 답을 얻기 쉽고, 큰 k에서의 값은 여러 번 생성했을 때 도달하는 해결 범위를 보여줌.
- Yue et al. (2025)는 이 구분을 활용해 검증 가능한 보상을 쓰는 RL (RLVR)과 base model의 추론 범위를 분석했음.
- 다만 DF-Sample의 Pass@1에는 이미 내부 트리 탐색이 들어감.
- 따라서 같은 k라고 해서 모델 호출 수나 토큰 예산까지 같은 것은 아님.
- 서비스에서 한 개의 답을 반환한다는 기준과 내부 계산을 한 번만 한다는 기준을 분리해야 함.
Power Sampling과 Tree of Thoughts
- Power Sampling은 Karan et al. (2025)의 방법으로, base model의 likelihood에 기반한 반복 sampling으로 추론 성능을 높임.
- 추가 학습이나 verifier를 요구하지 않는다는 점이 특징임.
- DF-Sample은 이를 주요 비교 대상으로 삼지만, 자신은 GPT-4o 평가를 추가함.
- 두 시스템의 차이는 경로를 탐색하는 방식뿐 아니라, 어떤 정보를 사용해 좋은 경로를 알아보는가에도 있음.
- 이 차이는 뒤의 성능 표를 해석할 때 계속 기억해야 함.
- Tree of Thoughts는 자연어 추론 단위를 노드로 삼아 여러 갈래를 탐색한다는 더 넓은 배경을 제공함.
- 따라서 DF-Sample의 새로움을 추론을 트리로 만들었다는 사실 하나로 설명하면 부정확함.
- 이 논문에서 집중해서 볼 부분은 생성 prior, 말단 에너지, 재귀적 효용 계산, posterior 선택이 연결되는 방식임.
- Sampling Decisions의 Decision Flow 관점을 언어모델 추론 경로에 적용한 것으로 읽으면 이 설계의 위치가 분명해짐.
방법 / 아키텍처 상세
1. Hierarchical reasoning tree: 경로 선택 전 후보 확장
- 트리의 노드와 생성 단위.
- 입력 문제: $q$. 현재 노드의 추론 텍스트: $s_v$. 앞선 경로: $s_{<v}$.
- DF-Sample은 각 부모 노드에서 K개의 다음 추론 단계를 독립적으로 생성함.
- 이를 L단계 반복하면 깊이가 L인 트리가 됨.
- 노드 하나는 토큰 하나가 아니라 추론 단계에 해당하는 텍스트 묶음임.
- 모델은 각 후보의 텍스트와 그 텍스트가 해당 문맥에서 생성될 log-probability를 함께 기록함.
\[\begin{aligned} &\log p(s_v\mid q,s_{<v})\\ &\quad=\sum_{t=1}^{|s_v|}\log p(w_t\mid q,s_{<v},w_{<t}). \end{aligned}\]
- 이 식은 현재 단계 안의 토큰 log-probability를 합한 것임.
- 최종 단계의 평균 likelihood와, 각 분기를 선택할 때 사용하는 prior가 같은 정규화를 쓰는 것은 아니라는 점에 주의해야 함.
- 뒤에서 말단 에너지는 단계 길이로 나누지만, 형제 노드의 prior는 본문의 정의상 위 합을 지수화한 값으로 계산함.
- 길이가 다른 후보를 생성하면 이 차이가 선택에 영향을 줄 수 있음.
- 후보 확장 → 말단 평가 → 경로 선택의 순서.
- 다음 단계 하나를 고르고 나머지를 버리는 방식에서는 탈락한 후보가 어떤 결론에 도달했을지 알 수 없음.
- DF-Sample은 현재 탐색 범위 안의 후보를 끝까지 확장하므로, 초반에는 확률이 낮았던 경로의 후속 결과도 평가할 기회를 얻음.
- 그러나 트리에 한 번도 들어오지 않은 경로를 발견하는 능력까지 생기지는 않음.
- 처음의 candidate generation이 탐색 가능한 범위를 정함.
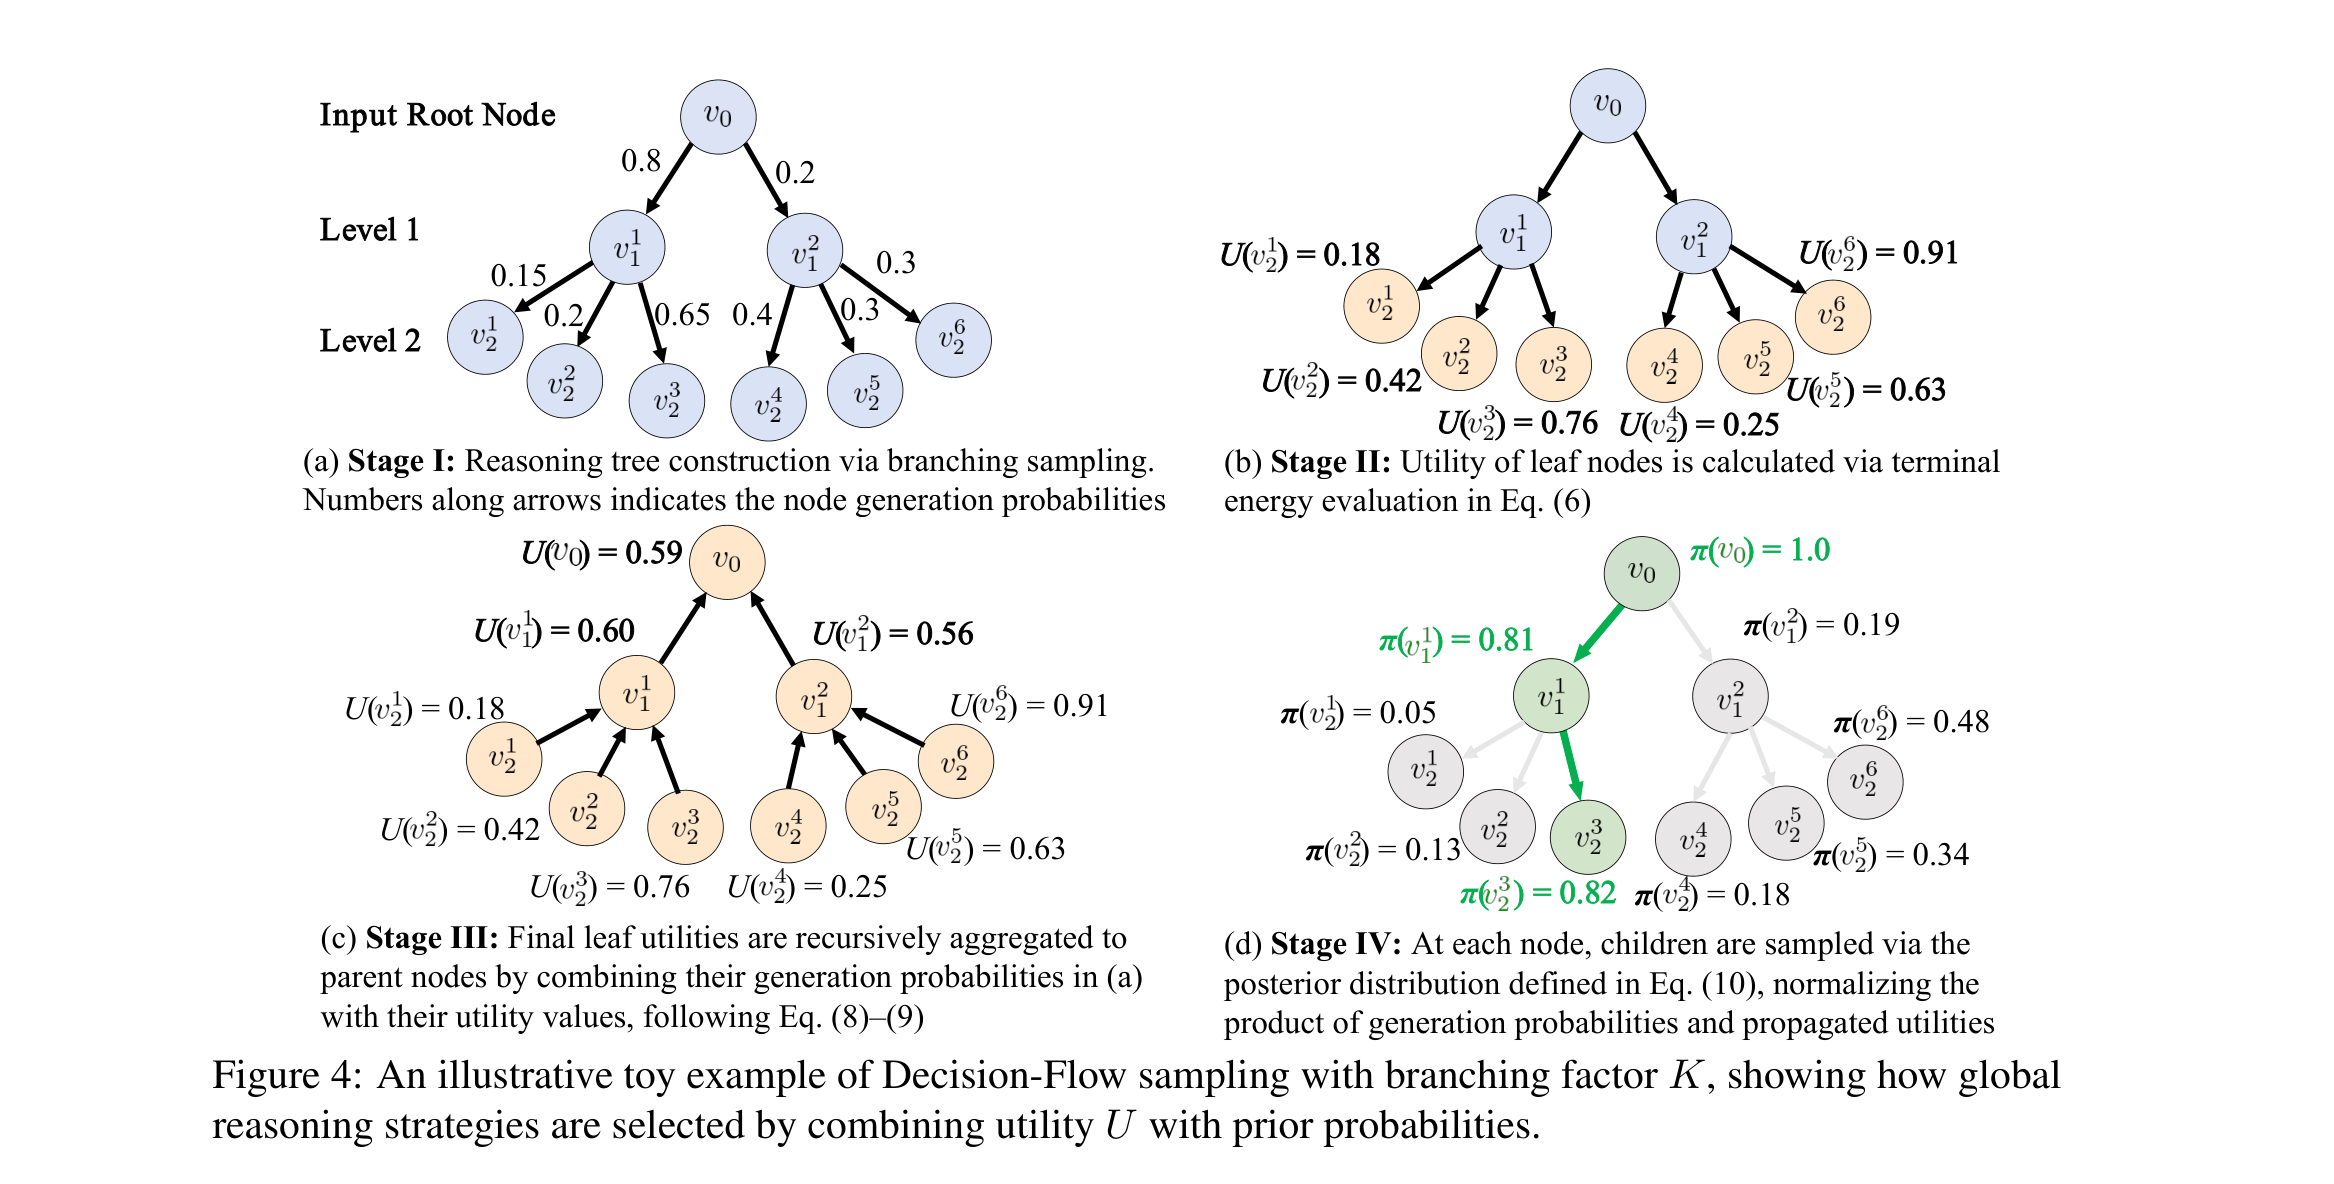 Figure 4: 후보 트리 생성 → 말단 평가 → 효용의 역방향 전달 → posterior 경로 선택. 그림 속 수치: 절차 설명용 예시.
2. Terminal energy: 마지막 단계의 확률과 품질 결합
- 완성된 경로의 말단 노드를 평가하는 이유는 마지막 추론 단계가 앞선 내용을 요약하고 결론을 담는 경우가 많기 때문임.
- 논문의 Figure 5는 자기 단극자가 존재하면 어떤 Maxwell 방정식이 달라지는지를 묻는 예시를 듦.
- 마지막 단계에는 자기장의 발산과 Gauss’s law for magnetism에 관한 결론이 모임.
- 이 설계에서는 그 결론부를 전체 경로 품질의 대리 신호로 사용함.
- 모든 중간 단계에 별도 점수를 매기는 과정은 아님.
- 깊이 L의 말단에서 에너지와 효용을 다음처럼 정의함.
\[\begin{aligned} E(v_L)&=-\alpha\frac{\log p(s_{v_L}\mid q,s_{<v_L})}{|s_{v_L}|}\\ &\quad+R(s_{v_L}),\\ U(v_L)&=\exp\bigl(-E(v_L)\bigr). \end{aligned}\]
- 첫 항은 마지막 단계의 토큰당 negative log-likelihood에 계수를 곱한 값임.
- 모델이 자신 있게 생성한 결론일수록 이 항이 작아짐.
- 두 번째 항 R은 논문이 quality score라고 부르는 값인데, 낮을수록 좋은 점수로 정의함.
- 그러므로 보통의 reward처럼 높은 값이 좋다고 읽으면 부호가 뒤집힘.
- 둘을 더한 에너지가 낮을수록 지수 변환 뒤의 효용은 커짐.
- 구현에서는 R을 GPT-4o로 평가함.
- 여기서 평가기와 생성기의 역할을 분리할 수 있음.
- 생성기는 자신의 확률로 결론의 익숙함을 측정하고, 평가기는 그 결론의 품질에 추가 신호를 줌.
- 하지만 평가기가 완벽하다는 가정은 실험으로 보장되지 않음.
- 오류가 앞쪽 추론에 숨어 있어도 마지막 문장이 설득력 있게 보이면 높은 효용을 받을 수 있음.
- 마지막 노드를 전체 경로의 대리 신호로 쓰는 계산 절약과, 과정의 오류를 놓칠 가능성이 함께 존재함.
3. Decision-Flow backward propagation: 자식 효용의 역방향 전달
- 부모 효용의 재귀적 계산.
- 부모 노드: v. 자식 집합: C(v). 개별 자식: u.
- 원문 식 (5), (6)을 이 표기로 다시 쓰면 다음과 같음.
- 문맥에는 입력 문제와 v까지의 경로가 포함됨.
\[\begin{aligned} \ell(u)&=\log p(s_u\mid q,s_{<u}),\\ p_{\mathrm{prior}}(u\mid v) &=\frac{\exp\ell(u)}{\sum_{z\in C(v)}\exp\ell(z)},\\ U(v)&=\sum_{u\in C(v)}p_{\mathrm{prior}}(u\mid v)U(u). \end{aligned}\]
- prior는 언어모델이 만들 수 있는 모든 다음 텍스트의 분포가 아님.
- 이미 뽑힌 K개의 후보 사이에서 확률을 다시 정규화한 값임.
- 부모의 효용은 이 prior로 가중한 자식 효용의 평균임.
- 따라서 부모 아래에 좋은 말단이 하나 있다고 해서 부모가 자동으로 최고 점수를 받지 않음.
- 그 말단에 도달하는 prior가 얼마나 되는지도 반영됨.
- 자식의 최대 점수를 그대로 부모에 붙이는 max backup과도 다름.
- 계산은 말단부터 루트 방향으로 진행함.
- 말단에 GPT-4o 기반 평가가 들어갔다면, 그 신호가 각 자식의 효용을 거쳐 앞쪽 분기의 전망으로 전달됨.
- 이 과정에서 모델 파라미터에 대한 미분이나 optimizer step은 없음.
- 이미 생성한 유한 트리 위에서 숫자를 합산할 뿐임.
- 따라서 이름에 backward propagation이 들어가더라도 학습 시간의 backpropagation으로 이해할 필요는 없음.
4. Posterior path selection: prior와 효용의 곱
- 모든 노드의 효용이 정해지면 루트에서 출발해 다음 분포로 자식을 하나씩 뽑음.
- 원문 식 (7)의 분모는 바로 앞에서 계산한 부모 효용과 같음.
\[\pi^*(u\mid v) =\frac{p_{\mathrm{prior}}(u\mid v)U(u)}{U(v)}.\]
- 이 식에서 효용이 모든 형제에게 같으면 선택은 prior와 같아짐.
- 반대로 어떤 후보가 낮은 prior를 갖더라도 충분히 높은 효용을 가지면 선택 확률을 높일 수 있음.
- 단, 이것은 최고 효용의 경로를 반드시 고르는 argmax가 아님.
- 실제 출력은 posterior에서 뽑은 경로임.
- 생성 경향과 품질 신호를 섞어 분포를 바꾸는 방식이므로, 확률적인 실패 가능성도 남음.
- Figure 4의 왼쪽 하위 트리: posterior 계산 예시.
- 세 자식의 prior는 0.15, 0.20, 0.65이고 효용은 0.18, 0.42, 0.76임.
- 가중합은 0.605임.
- 따라서 세 번째 자식의 posterior 확률은 0.65와 0.76의 곱을 0.605로 나눈 약 0.817임.
- 원문 그림의 0.82에 해당함.
- 이 값은 정답일 확률 82%라는 뜻이 아님.
- 만들어 놓은 세 후보 사이에서 그 자식을 고르는 확률임.
- 효용 역시 보정된 정답 확률로 해석할 근거가 없음.
- 선택한 경로에 명시적 최종 답이 있으면 그대로 출력함.
- 없으면 선택한 경로를 원래 질문에 붙여 최종 답을 추가 생성함.
- 따라서 탐색 알고리즘의 직접 출력인 추론 chain과 사용자에게 반환할 final answer를 구분해야 함.
- 원문 Algorithm 1의 입력은 질문, 모델, 분기 수 K, 전체 깊이 N, 블록 크기 B, 계수 alpha이며, 출력은 선택된 추론 chain임.
- 완성된 답을 만드는 후처리는 본문 4.4절에 설명되어 있음.
5. Block-wise sampling: 일정 깊이의 부분 경로 탐색
- 추론이 길어지면 완전한 트리 생성은 금방 비싸짐.
- 노드마다 K개로 분기하고 깊이가 L이면 말단만 K의 L제곱 개가 됨.
- 논문은 먼저 모델이 필요한 추론 단계 수 N을 추정하게 하고, N이 블록 크기 B보다 크면 B단계만 탐색함.
- 그중 경로 하나를 선택해 질문의 문맥에 붙인 뒤 다음 블록을 생성함.
- 마지막 블록의 길이는 남은 단계 수에 맞춤.
- 기본 실험 설정은 K=3, B=3임.
- 완전히 확장한 기본 블록 하나에는 루트를 제외하고 3+9+27=39개의 후보 노드와 27개의 말단이 생김.
- 이는 트리 구조에서 계산한 개수이며 실제 API 요청 수를 측정한 값은 아님.
- 배치 평가 여부나 조기 종료에 따라 호출 수와 실행 시간이 달라질 수 있음.
- 그래도 최종 결과가 세 단계여도 그 뒤에서 훨씬 많은 텍스트를 생성하고 평가한다는 점을 이해하는 데 도움이 됨.
- 비용을 줄이는 대신 관찰 범위도 줄어듦.
- 전체 풀이가 여러 블록으로 나뉘면 앞 블록을 고를 때 아직 생성하지 않은 뒤 블록의 결론은 볼 수 없음.
- 한 번 버린 앞쪽 가지로 되돌아가는 단계도 제시된 알고리즘에는 없음.
- 그러므로 여기서 global trajectory evaluation이라는 표현은 주어진 탐색 트리의 말단 정보를 사용한다는 뜻으로 읽는 것이 정확함.
- 모든 미래 풀이를 끝까지 검증하고 전체 최적 경로를 찾는다는 의미는 아님.
추론 목표 / 에너지 함수
Terminal utility가 만드는 경로 분포
- DF-Sample에는 새로 최소화하는 학습 손실이 없음.
- 핵심 목표는 고정된 생성 모델의 후보 중, likelihood와 품질을 결합한 효용이 높은 경로가 더 자주 선택되게 하는 것임.
- 말단 효용을 에너지 식에 대입하면 다음처럼 읽을 수 있음.
\[\begin{aligned} U(v_L)=\exp\Bigl(&\alpha\frac{\log p(s_{v_L}\mid q,s_{<v_L})}{|s_{v_L}|}\\ &-R(s_{v_L})\Bigr). \end{aligned}\]
- alpha는 이 에너지에서 likelihood의 영향력을 조절하는 계수임.
- 구현의 기본값은 4.0임.
- 일반적인 token sampling temperature와 무조건 같은 값으로 취급하면 안 됨.
- alpha가 커지면 likelihood 항의 차이가 효용에 더 크게 반영됨.
- 반면 R의 척도도 지수 안에 직접 들어가므로 평가 점수의 범위와 변환 방식이 중요함.
- 같은 상대 순위를 주는 평가기라도 점수 간격이 달라지면 posterior의 집중 정도가 달라질 수 있음.
- 리뷰어의 유도: 고정된 트리에서의 경로 분포.
- 고정된 한 트리에서 루트부터 말단까지 선택 확률을 곱하면, 중간 노드의 효용은 분자와 분모에서 상쇄됨.
- 그 결과 경로의 prior에 말단 효용을 곱한 분포를 얻음.
\[\begin{aligned} \pi^*(\tau) &=\prod_{(v,u)\in\tau} \frac{p_{\mathrm{prior}}(u\mid v)U(u)}{U(v)},\\ &=P_{\mathrm{prior}}(\tau)\frac{U(v_L)}{U(v_0)}. \end{aligned}\]
- 이 유도는 효용을 뒤로 전달하는 이유를 설명함.
- 중간 결정마다 말단의 평가를 일관되게 반영하면, 경로 전체로 보았을 때도 같은 평가에 따라 가중된 sampling이 됨.
- 그러나 이는 이미 생성한 트리 안의 항등식임.
- 원래 언어모델의 모든 가능한 문자열 공간에 대한 정확한 sampling을 증명한 것이 아니며, 평가기의 점수가 실제 정답성을 완벽히 나타낸다는 뜻도 아님.
- 블록을 이어 붙인 전체 풀이에 그대로 전역 최적성 보장을 부여할 수도 없음.
평가 데이터와 파이프라인
네 벤치마크와 두 평가기의 역할
- 논문은 아래 네 과제를 사용함.
- 수학·코드·과학에서는 정답 여부를, 일반 지시 수행에서는 비교 평가에 따른 승률을 봄.
- 하나의 평균 점수로 합치기보다 과제마다 다른 실패 조건과 척도를 유지해 읽는 편이 나음.
| 벤치마크 | 규모 | 평가 대상 |
| MATH500 | 500문제 | 경쟁 수학 문제의 정답률 |
| HumanEval | 164과제 | 생성 코드가 해당 unit test를 모두 통과하는지 |
| GPQA-Diamond | 198문제 | 물리·화학·생물의 대학원 수준 객관식 정답률 |
| AlpacaEval 2.0 | 805프롬프트 | GPT-4-Turbo 판정에 따른 길이 보정 승률 |
- 두 평가기의 역할과 비용 구분.
- GPT-4-Turbo: AlpacaEval의 최종 답변 비교 평가기.
- DF-Sample의 트리 말단에서 R을 계산하는 GPT-4o와 역할이 다름.
- 전자는 결과를 측정하는 단계에, 후자는 어떤 결과를 출력할지 결정하는 추론 과정 안에 들어감.
- 두 이름을 혼용하면 시스템의 정보 흐름이 달라짐.
- 특히 후자의 비용과 판단 능력은 DF-Sample 자체의 자원으로 계산해야 함.
모델·비교 기준·하이퍼파라미터
| 항목 | 논문에 보고된 설정 |
| 생성 모델 | Qwen2.5-Math-7B, Qwen2.5-7B, Phi-3.5-mini-instruct |
| 비교 방법 | Base greedy decoding, Low-temperature, GRPO (MATH), Power Sampling |
| 기본 분기·블록 크기 | K=3, B=3 |
| 에너지의 likelihood 계수 | alpha=4.0 |
| 말단 품질 평가 | GPT-4o |
| 실행 자원 | NVIDIA A6000 GPU 2개 |
| 그 외 하이퍼파라미터 | Power Sampling과 일치시켰다고 기술 |
| baseline 수치 출처 | Karan et al. (2025)의 결과를 가져옴 |
- 세 모델을 모두 아무 post-training도 거치지 않은 순수 base checkpoint라고 부르면 안 됨.
- 이름에 명시되어 있듯 Phi는 instruct 모델임.
- 이 논문의 training-free 주장은 사용한 생성 모델을 DF-Sample로 추가 학습하지 않는다는 뜻임.
- 외부 평가기가 가진 지식도 사라지는 것은 아님.
- 마찬가지로 data-free라는 표현은 새 학습 데이터셋을 만들어 fine-tuning하지 않는다는 범위에서 이해해야 함.
- 재현성 측면에서 가장 필요한 정보는 말단 R의 평가 prompt와 점수 척도, 추론 단계의 경계, N을 추정하는 구체적 절차임.
- 논문은 GPT-4o 사용과 큰 흐름은 밝히지만, 이를 같은 조건으로 재실행할 만큼 상세하게 제시하지는 않음.
- baseline을 모두 동일한 실행 환경에서 다시 평가한 실험도 아님.
- 따라서 표의 수치는 보고 결과로 존중하되, 작은 차이를 순수한 알고리즘 효과로 확정하기에는 비교 조건이 충분히 통제되지 않았음.
실험 결과
Table 1: 모델별 최고 결과와 예외
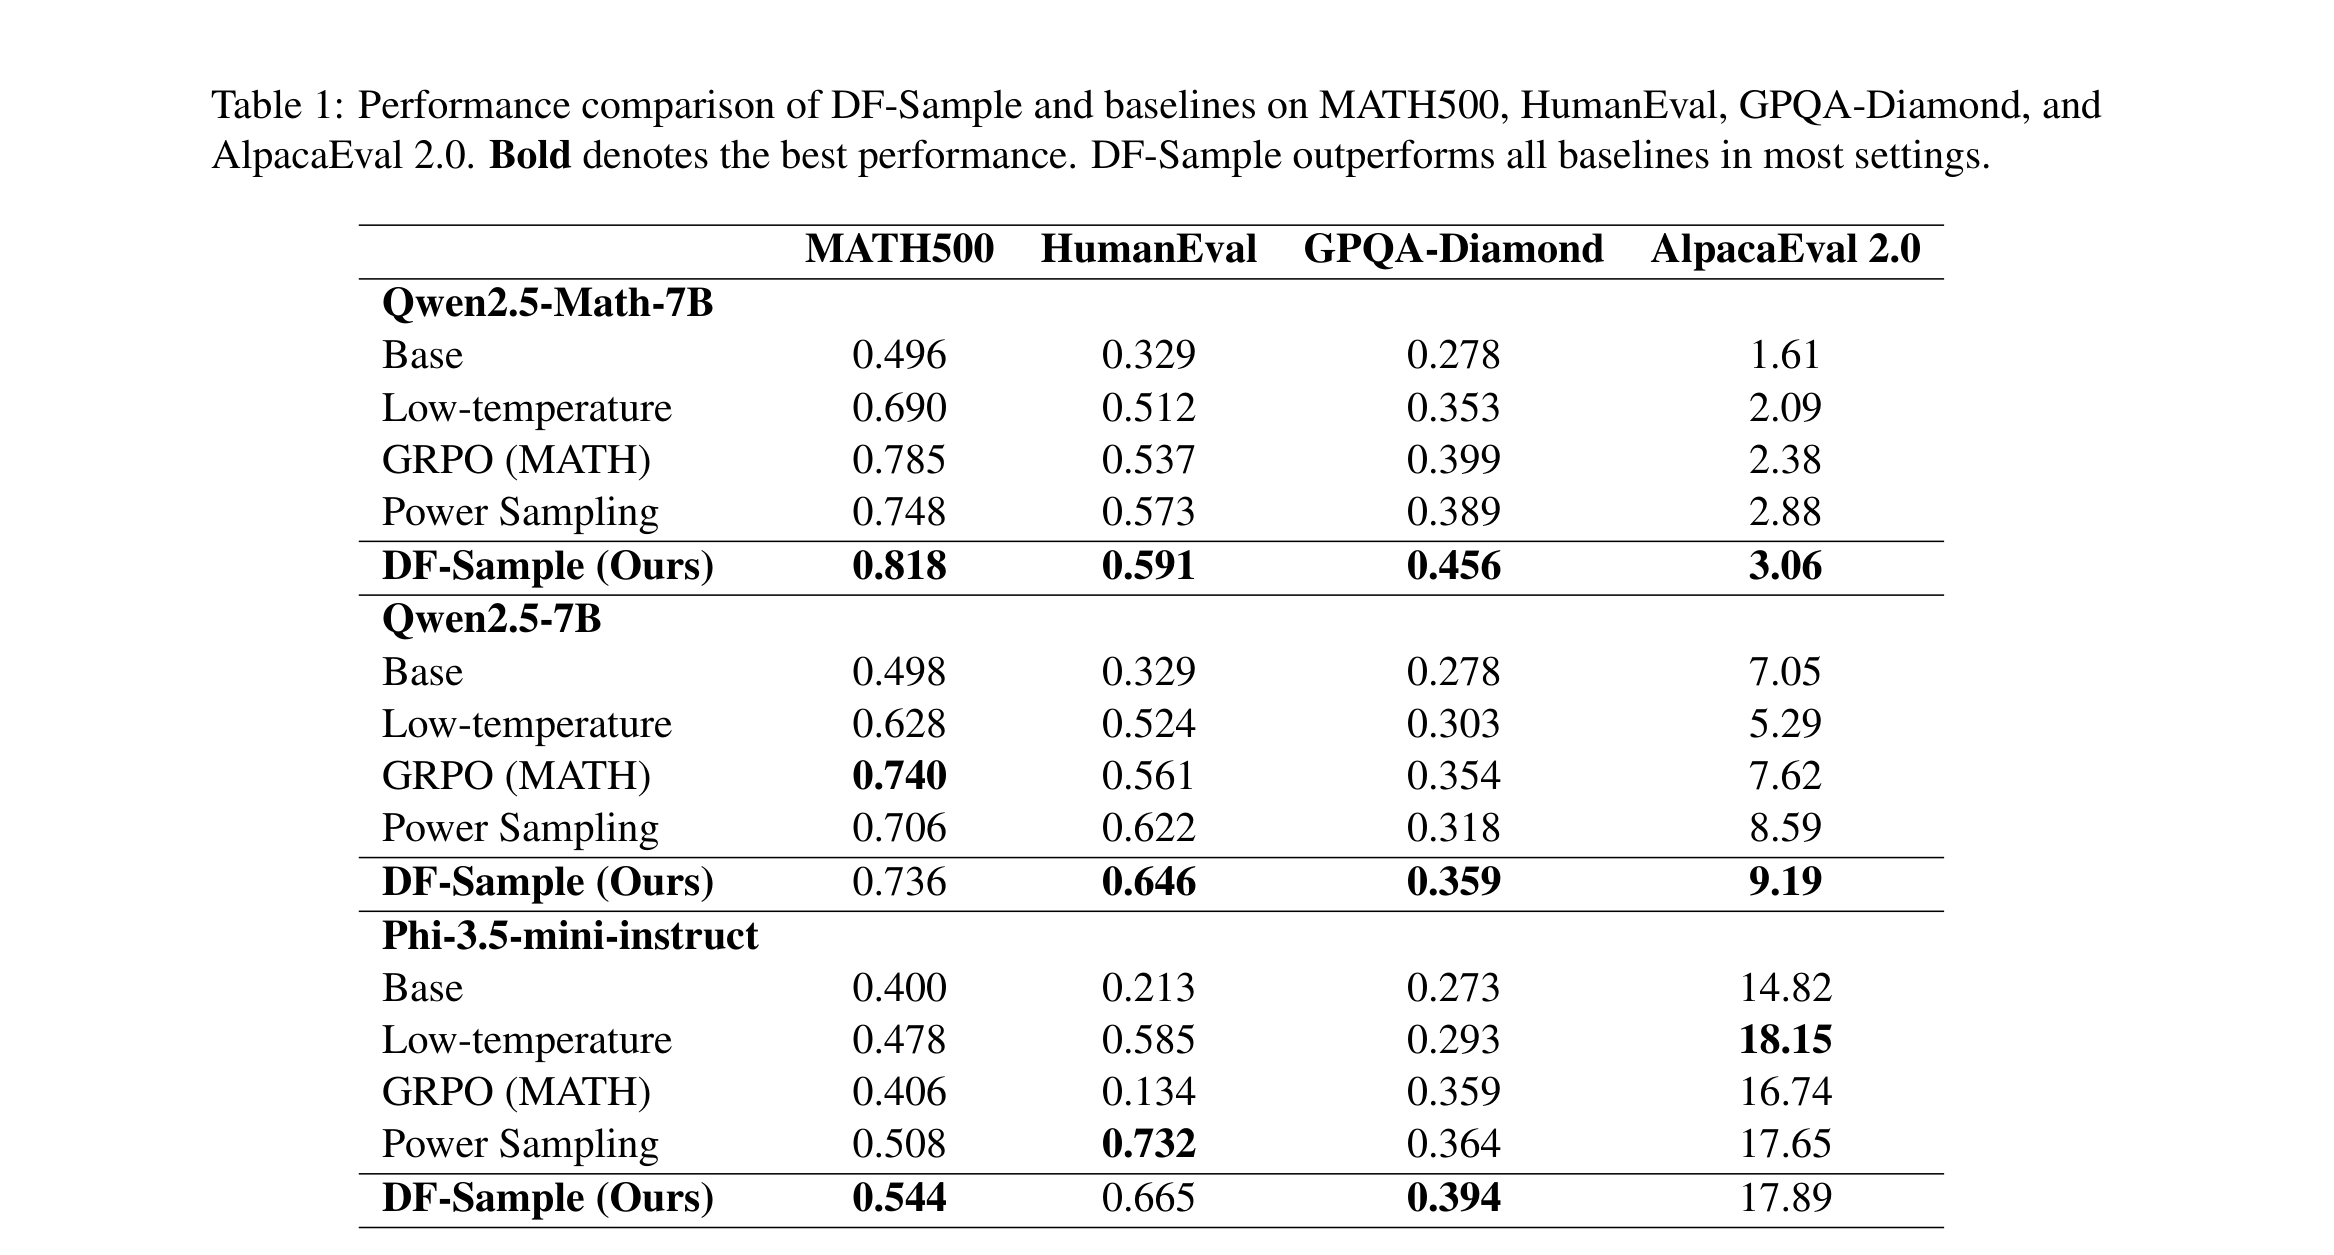 Table 1: 모델 3개와 벤치마크 4개의 성능 비교. 첫 세 열: 소수로 표기한 정답률. AlpacaEval 2.0: 길이 보정 승률.
- DF-Sample은 세 모델의 네 벤치마크 모두에서 각 Base 행보다 높음.
- 하지만 모든 baseline보다 항상 높지는 않음.
- 아래는 Table 1의 정답률을 백분율로 바꾸고, DF-Sample과 각 셀의 가장 높은 다른 baseline을 비교한 표임.
- AlpacaEval은 원래 승률 숫자를 유지했음.
- 세 번째 열의 숫자는 리뷰에서 계산한 차이이며, 원문에 없는 새로운 실험은 아님.
| 모델 · 과제 | DF-Sample / 가장 높은 baseline | 차이 |
| Qwen2.5-Math-7B · MATH500 | 81.8 / GRPO 78.5 | +3.3%p |
| Qwen2.5-Math-7B · HumanEval | 59.1 / Power Sampling 57.3 | +1.8%p |
| Qwen2.5-Math-7B · GPQA-Diamond | 45.6 / GRPO 39.9 | +5.7%p |
| Qwen2.5-Math-7B · AlpacaEval 2.0 | 3.06 / Power Sampling 2.88 | +0.18 |
| Qwen2.5-7B · MATH500 | 73.6 / GRPO 74.0 | −0.4%p |
| Qwen2.5-7B · HumanEval | 64.6 / Power Sampling 62.2 | +2.4%p |
| Qwen2.5-7B · GPQA-Diamond | 35.9 / GRPO 35.4 | +0.5%p |
| Qwen2.5-7B · AlpacaEval 2.0 | 9.19 / Power Sampling 8.59 | +0.60 |
| Phi-3.5-mini-instruct · MATH500 | 54.4 / Power Sampling 50.8 | +3.6%p |
| Phi-3.5-mini-instruct · HumanEval | 66.5 / Power Sampling 73.2 | −6.7%p |
| Phi-3.5-mini-instruct · GPQA-Diamond | 39.4 / Power Sampling 36.4 | +3.0%p |
| Phi-3.5-mini-instruct · AlpacaEval 2.0 | 17.89 / Low-temperature 18.15 | −0.26 |
GPQA-Diamond와 MATH500
- 가장 눈에 띄는 GPQA-Diamond 결과는 Qwen2.5-Math-7B의 45.6%임.
- GRPO 39.9%보다 5.7%p, Power Sampling 38.9%보다 6.7%p 높음.
- 이는 45.6%라는 절대 정답률이므로, 이미 과학 추론 문제를 안정적으로 해결한다는 의미는 아님.
- 다만 같은 생성 모델에서 출력 경로의 구성과 평가 방식을 바꾸면 상당한 차이가 나타난다는 사례로는 설득력이 있음.
- 저자는 여러 단계의 과학 추론이 전체 경로 평가에 특히 적합하다고 해석하지만, 그 원인을 직접 분리한 실험은 없음.
- MATH500에서는 Qwen2.5-Math-7B가 81.8%로 GRPO 78.5%와 Power Sampling 74.8%를 앞섬.
- Power Sampling과의 차이는 7.0%p임.
- 반면 일반 Qwen2.5-7B에서는 DF-Sample 73.6%, GRPO 74.0%로 순서가 바뀜.
- 같은 수학 벤치마크에서도 생성 모델에 따라 상대적 이득이 다르다는 뜻임.
- 수학 모델에서 얻은 대표 결과 하나로 모든 checkpoint에서 RL보다 좋다고 일반화할 수 없음.
HumanEval과 AlpacaEval 2.0
- HumanEval에서는 Qwen2.5-7B의 DF-Sample이 64.6%로 Power Sampling 62.2%를 앞섬.
- 하지만 Phi-3.5-mini-instruct에서는 66.5%로 Power Sampling 73.2%보다 낮음.
- 이 6.7%p 차이는 단순히 모든 과제에서 비슷하게 좋은 결과가 나왔다는 서술로 덮기 어려움.
- 코드 생성에서는 말단의 자연어 품질 평가가 실행 가능한 정확성을 얼마나 잘 대변하는지 따로 확인할 필요가 있음.
- 이 논문은 해당 역전의 원인을 평가기 오류나 탐색 실패로 분해하지 않음.
- AlpacaEval 2.0에서 DF-Sample의 보고 승률은 각각 3.06, 9.19, 17.89임.
- 같은 세 모델의 Base 값 1.61, 7.05, 14.82보다는 높음.
- 다만 Phi의 Low-temperature 18.15보다 낮으므로, 일반 지시 수행에서도 트리 탐색이 가장 간단한 decoding보다 항상 우수하지는 않음.
- 이 지표는 상대 답변과 평가자의 판정에 따른 승률임.
- 이를 MATH500의 정답률처럼 읽거나, 숫자가 크다는 이유만으로 세 생성 모델의 전체 능력을 같은 척도에서 비교해서는 안 됨.
응답 길이와 문제당 latency
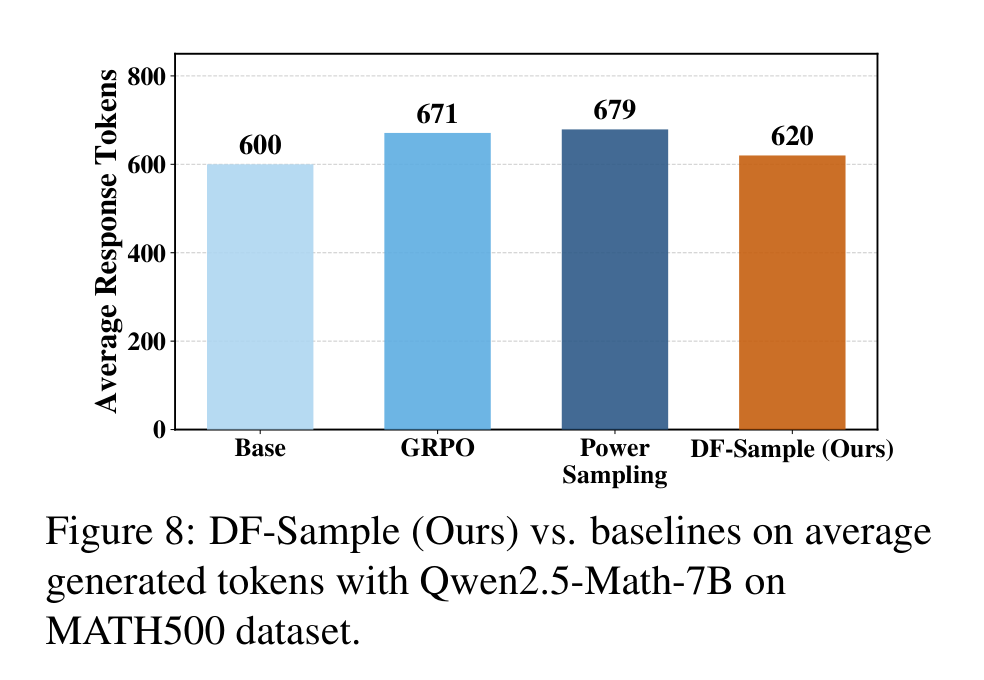 Figure 8: Qwen2.5-Math-7B의 MATH500 평균 최종 답변 길이. Base 600, GRPO 671, Power Sampling 679, DF-Sample 620토큰. 탐색 중 폐기한 후보의 토큰은 제외.
- Figure 8에서 DF-Sample의 최종 답변은 620토큰으로 Base 600토큰에 가까움.
- 본문은 약 619토큰이라고 설명하지만, 여기서는 그림의 라벨을 따름.
- Power Sampling 679토큰과 GRPO 671토큰보다 답변이 짧다는 점은 출력의 간결함에 관한 관찰임.
- 내부에서는 선택되지 않은 다른 가지도 생성했으므로, 이 그림만으로 시스템 전체가 더 적은 토큰을 썼다고 판단할 수 없음.
- 말단의 GPT-4o 평가에 쓰인 토큰도 별도로 고려해야 함.
- 논문이 보고한 Qwen2.5-Math-7B의 MATH500 문제당 시간은 Power Sampling 약 340초, DF-Sample 약 384초임.
- 주어진 숫자로 계산하면 약 44초, 약 12.9%의 시간 증가.
- 정확도는 74.8%에서 81.8%로 높아졌으므로 해당 조건에서 품질과 시간을 교환한 결과로 볼 수 있음.
- 다만 전체 생성 토큰 수, 평가기 사용 요금, latency 분포와 세부 시간 분해는 제시되지 않음.
- 이 두 평균 시간만으로 다른 모델이나 서비스 환경의 비용을 예측하기는 어려움.
결과 분석 / Ablation
Likelihood와 token confidence의 차이
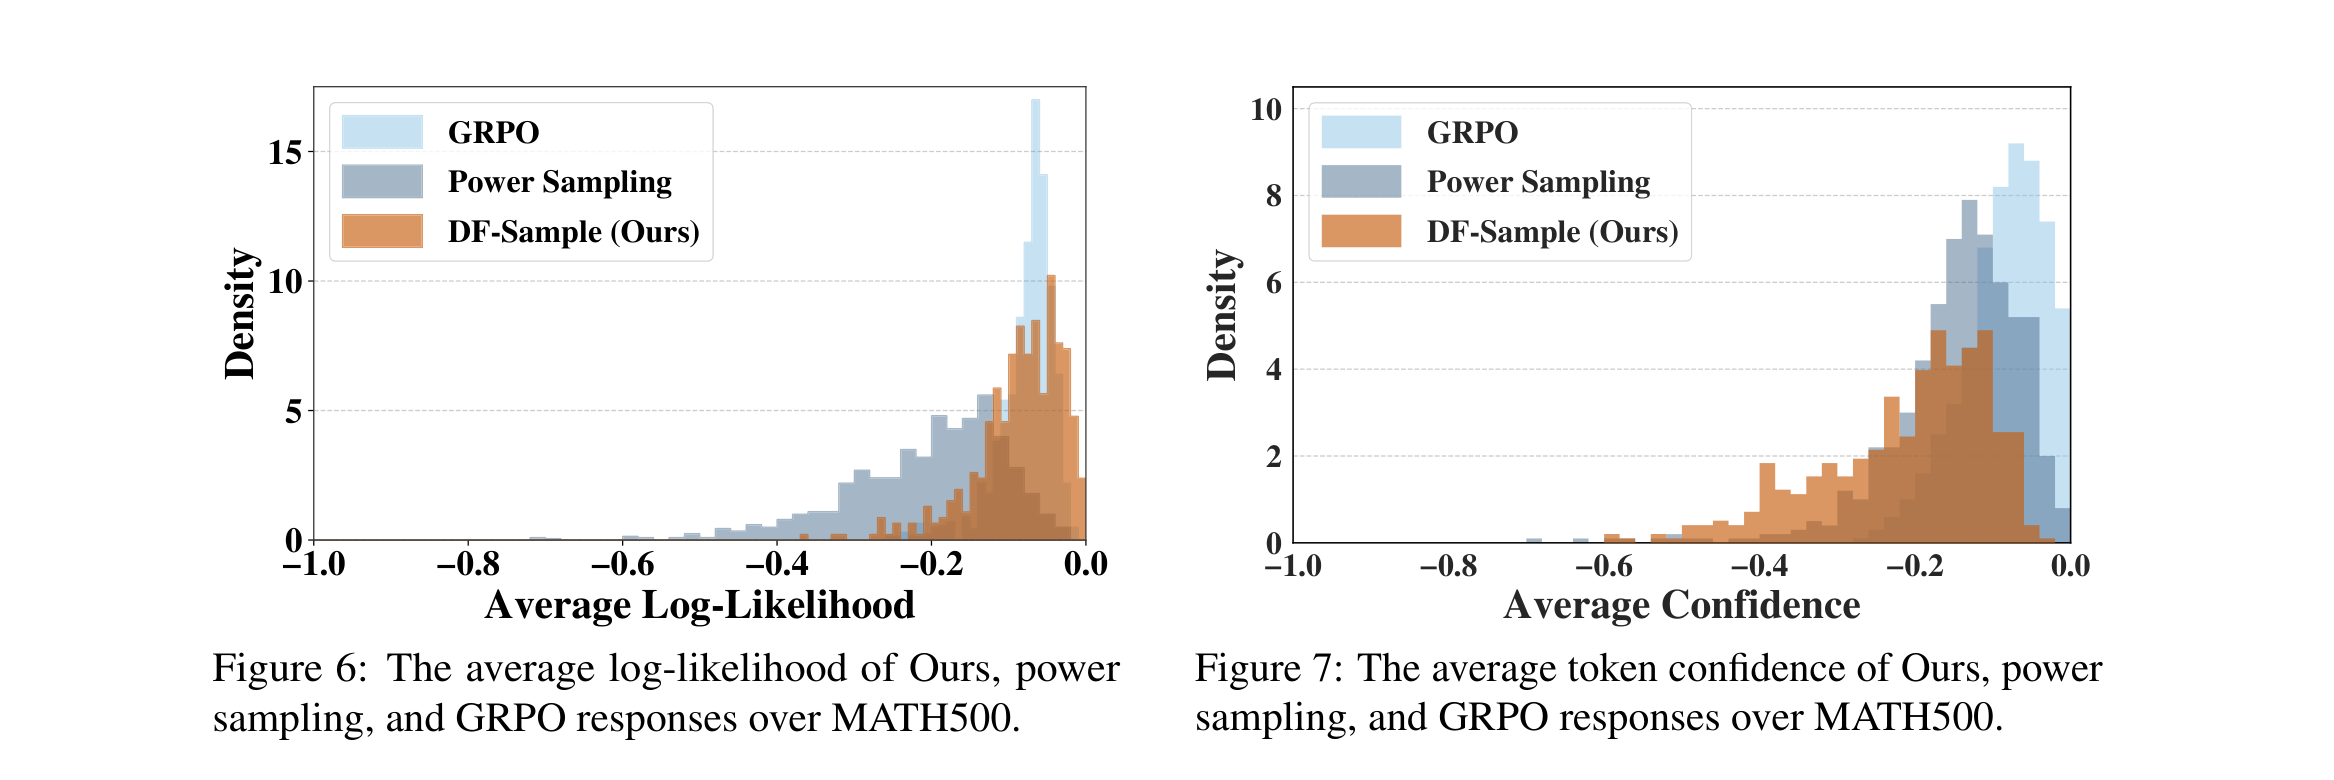 Figures 6–7: MATH500 응답의 평균 log-likelihood와 token confidence 분포. 오른쪽 confidence: 평균 entropy의 음수.
- 두 분포가 측정하는 대상.
- Figure 6의 평균 log-likelihood: 실제로 생성한 토큰열이 모델 아래에서 갖는 확률.
- Figure 7의 token confidence: 각 위치에서 가능한 다음 토큰 분포 전체의 불확실성.
- 논문의 confidence 식을 읽기 쉽게 두 줄로 쓰면 다음과 같음.
- 원문과 같이 위치는 0부터 T까지이며, X는 vocabulary임.
\[\begin{aligned} H_t&=-\sum_{x\in\mathcal X} p(x\mid x_{<t})\log p(x\mid x_{<t}),\\ \mathrm{Conf}(x_{0:T})&=-\frac{1}{T+1}\sum_{t=0}^{T}H_t. \end{aligned}\]
- 즉 confidence는 평균 entropy의 음수임.
- 값이 0에 가까우면 다음 토큰 분포가 집중되어 있고, 더 음수이면 불확실성이 큼.
- DF-Sample은 Figure 7에서 낮은 confidence 쪽으로 더 넓게 퍼지고, GRPO는 높은 confidence 쪽으로 집중됨.
- 저자는 이를 locally uncertain하지만 유용한 경로를 찾는다는 증거로 해석함.
- 다만 그래프 자체는 정답과 오답을 나누어 보여주지 않음.
- 불확실한 구간을 통과했다는 관찰과 그 구간이 정답을 만들었다는 인과 주장은 구분해야 함.
GPQA-Diamond: 분기 수 K
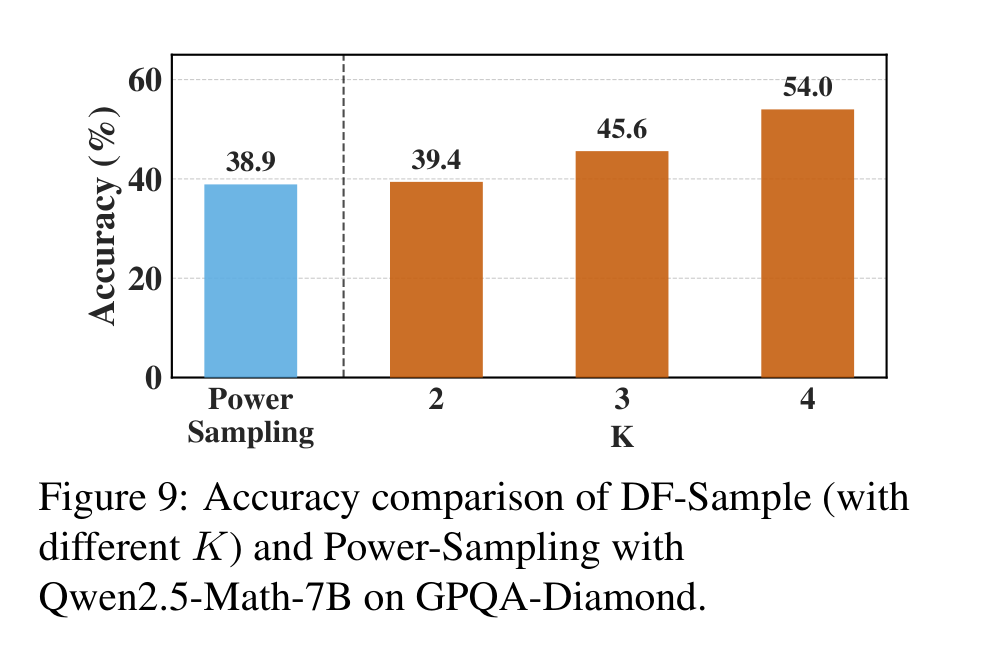 Figure 9: 분기 수 K에 따른 Qwen2.5-Math-7B의 GPQA-Diamond 정답률. K=2, 3, 4에서 각각 39.4%, 45.6%, 54.0%.
- 분기 수를 2, 3, 4로 늘리면 정답률이 39.4%, 45.6%, 54.0%로 높아짐.
- Power Sampling 38.9%와 비교한 차이는 각각 0.5%p, 6.7%p, 15.1%p임.
- 이 값들은 Figure 9에서 직접 계산한 차이.
- 넓게 탐색할수록 좋은 후보를 만날 기회가 늘어난다는 해석과 일치함.
- 하지만 분기 수의 효과는 단지 알고리즘 설정 하나의 변화가 아니라, 더 많은 후보 생성과 평가에 투자한 결과이기도 함.
- B=3인 완전한 블록을 가정하면 K=2일 때 후보 노드는 14개, 말단은 8개임.
- K=3이면 39개와 27개, K=4이면 84개와 64개임.
- 이 역시 구조에서 계산한 값임.
- 따라서 K=3에서 4로 한 칸 올리는 일은 작은 비용 증가라고 보기 어려움.
- 저자는 효율과 정확도의 균형을 이유로 기본값 3을 사용하지만, 이 ablation에 각 K의 측정 latency나 평가 요금이 함께 나오지는 않음.
- 54.0%를 무료 성능 향상처럼 읽어서는 안 됨.
Pass@k와 에너지 계수 alpha
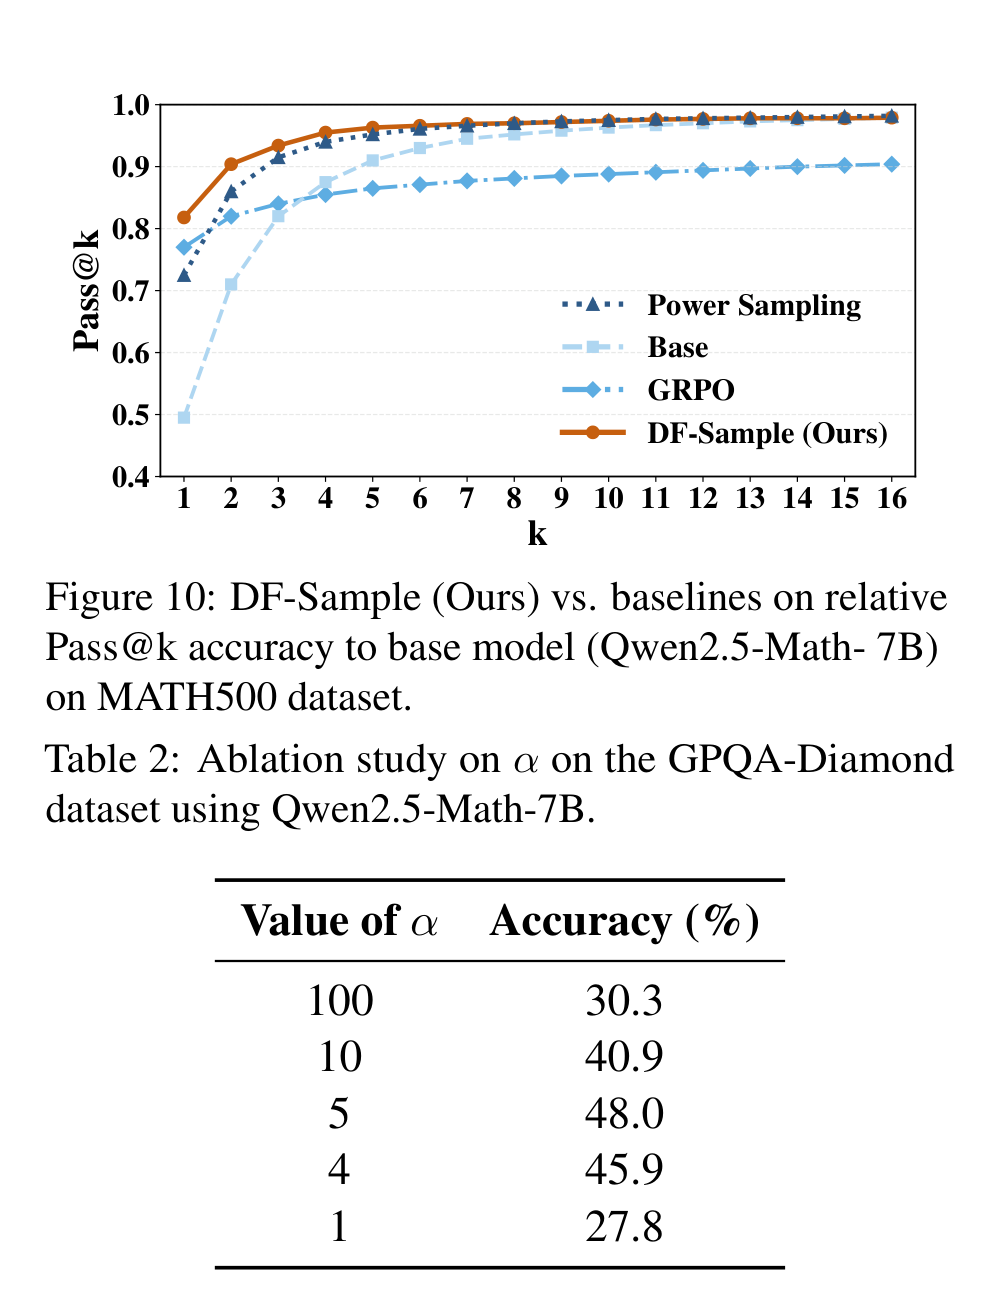 Figure 10·Table 2: 위: MATH500 Pass@k. 아래: GPQA-Diamond alpha ablation. Table 2의 alpha=4 정답률: 45.9%. 메인 Table 1의 45.6%와 불일치.
- Figure 10에서 DF-Sample의 이점은 Pass@1과 Pass@2에서 가장 분명함.
- k가 커지면 Power Sampling과 가까워지고, 일부 큰 k에서는 Power Sampling이 조금 앞섬.
- 이는 낮은 출력 횟수에서 좋은 경로를 잘 골라낸다는 주장과 맞음.
- 동시에 base model도 여러 번 샘플링하면 높은 범위에 도달함.
- 하지만 Pass@k는 후보 중 정답이 존재하는지 보는 지표이므로, 정답을 모르는 사용자가 그중 무엇을 고를지는 또 다른 선택 문제로 남음.
- Table 2는 alpha를 100, 10, 5, 4, 1로 바꿀 때 GPQA-Diamond 정답률을 각각 30.3%, 40.9%, 48.0%, 45.9%, 27.8%로 보고함.
- 높은 likelihood만 지나치게 선호하면 성능이 떨어지고, 이 실험에서는 중간 크기의 계수가 유리함.
- 다만 alpha=4의 45.9%와 메인 결과 45.6%는 일치하지 않음.
- 반복 실행이나 평가 조건 차이인지 설명되지 않아 두 값을 임의로 하나로 합치지 않았음.
- 특히 이 표만 보고 5가 모든 과제에 통하는 최적 설정이라고 말할 수는 없음.
한계와 비판적 평가
GPT-4o 평가와 트리 탐색의 기여 분리 부재
- 가장 큰 해석상의 제약은 외부 평가기의 존재임.
- DF-Sample이 생성 모델을 학습하지 않는다는 사실은 명확하지만, 좋은 경로를 알아보는 판단 능력 일부는 GPT-4o에서 옴.
- 생성 모델 혼자 만든 후보에 정답이 포함된다는 주장과, 그 모델 혼자 정답을 골라낼 수 있다는 주장은 다름.
- 여기서는 전자를 활용하기 위해 별도 모델의 판단을 사용함.
- 이는 유효한 시스템 설계지만, base model의 능력만으로 얻은 성능이라고 설명하면 평가기의 역할을 지우게 됨.
- 이를 분리하려면 같은 후보 예산과 같은 GPT-4o 평가기를 사용하는 Best-of-N, 평가기 없이 likelihood만 쓰는 DF-Sample, 같은 트리에서 다른 backup·선택 규칙을 사용하는 비교가 필요함.
- 현재 K와 alpha ablation은 설정 민감도를 보여주지만, backward utility propagation이 단순한 강한 평가기 추가보다 얼마나 더 기여했는지를 답하지 않음.
- 이 비교가 없으므로 성능 개선 전체를 Decision-Flow 규칙 하나의 효과로 귀속하기 어려움.
말단 평가와 블록 경계에서 생기는 오류
- 마지막 문장은 앞선 추론을 잘 요약할 수도 있지만, 잘못된 근거를 생략한 채 자신 있는 결론만 제시할 수도 있음.
- 논문은 말단 평가와 전체 chain 평가, process-level 평가를 직접 비교하지 않음.
- 특히 블록으로 나누면 말단이 문제 전체의 최종 결론이 아닐 수 있음.
- 그런 부분 경로의 품질을 어떤 rubric으로 판정하는지까지 분명해야 긴 추론에서 같은 방식이 작동할지 판단할 수 있음.
- 또한 N을 너무 짧게 추정하면 필요한 추론이 끝나기 전에 탐색이 멈추고, 너무 길면 불필요한 확장이 늘어날 수 있음.
- B를 작게 유지하는 방식은 계산량을 제한하지만, 앞 블록의 선택이 뒤에서 틀렸다고 드러났을 때 복구하는 절차는 없음.
- 따라서 긴 의존 관계를 가진 문제에서 어떤 오류가 남는지, 깊이를 바꾸면 품질과 비용이 어떻게 움직이는지에 관한 분석이 추가로 필요함.
비교 예산·불확실성·재사용 비용
- baseline 수치는 선행 논문에서 가져왔고, 모든 시스템을 동일 예산과 동일 evaluator로 다시 실행한 비교는 아님.
- 세 모델 중 하나는 instruct checkpoint이며, GRPO 비교는 MATH 설정임.
- 이 범위를 넘어 다른 RL 훈련 방식이나 더 큰 모델에서도 같은 우열이 유지된다고 말할 근거는 부족함.
- 작은 정답률 차이에 대해 반복 실행 분산이나 신뢰구간도 제시되지 않아, 수치가 조금 높은 경우까지 안정적인 우위로 확정하기 어려움.
- 저자가 직접 제시한 후속 과제는 탐색으로 얻은 좋은 경로를 학습으로 다시 모델에 넣는 것임.
- 현재 방식은 질문마다 검색 비용을 지불하지만, distillation이 성공하면 일부 비용을 학습 단계로 옮길 수 있음.
- 다만 이 논문은 그 실험까지 수행하지 않았음.
- 결국 실용적 선택은 학습 비용을 아낄지, 반복되는 추론 비용을 아낄지, 외부 평가기의 판단과 비용을 받아들일지에 달려 있음.
- 현재 결과는 그 선택의 한쪽 가능성을 보여줌.
시사점 / Takeaways
- 생성할 수 있는 능력과 선택할 수 있는 능력을 따로 측정해야 함.
- 후보 중 정답이 존재하는 비율, 선택 후 정답률, 그 선택에 들어간 평가기 자원을 함께 보면 sampling 개선의 출처가 드러남.
- 효용 역전파는 앞선 선택을 후속 결과와 연결하는 간단한 계산임.
- 부모가 자식의 기대 효용을 받고, 다음 선택이 prior와 효용의 곱을 따르는 구조를 이해하면 복잡한 이름보다 실제 작동 원리가 잘 보임.
- Training-free 시스템도 외부 지식과 계산을 사용할 수 있음.
- DF-Sample의 GPT-4o를 빼고 해석하거나, Power Sampling과의 차이를 트리 구조 하나로 설명하면 핵심 비교 조건을 놓침.
- 짧은 답변과 저렴한 추론은 다른 성질임.
- 최종 620토큰 뒤에 후보 트리와 평가 호출이 있음.
- 운영 판단에는 선택한 경로의 길이보다 총 생성량과 전체 latency가 필요함.
- RL과 탐색의 관계는 대체 여부만으로 정리되지 않음.
- 이 논문은 추가 학습 없이 성능을 올리는 구성을 보여주며, 발견한 경로를 다시 학습하는 결합 방식은 후속 검증 대상으로 남김.
참고 자료
더 읽어보기


