-
[논문 리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
JEV의 확신도로 저비용 판정을 채택하고 어려운 사례만 추론 모델에 넘기는 평가 cascade의 성능, 비용, 실패 조건
-
[논문 리뷰] BazaarBench: Delegation Safety in Decentralized C2C Marketplaces Run by LLM Agents
LLM 중고거래 시장의 재고·약속·개인정보 실패와 일반 지시, 마감 압박, 악의적 지시의 비교
-
[논문 리뷰] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
반복적인 하네스 개선의 benchmark 과적합을 proposal·selection 규제로 줄이는 RRSI의 방법, 전이 성능, 비용과 한계.
-
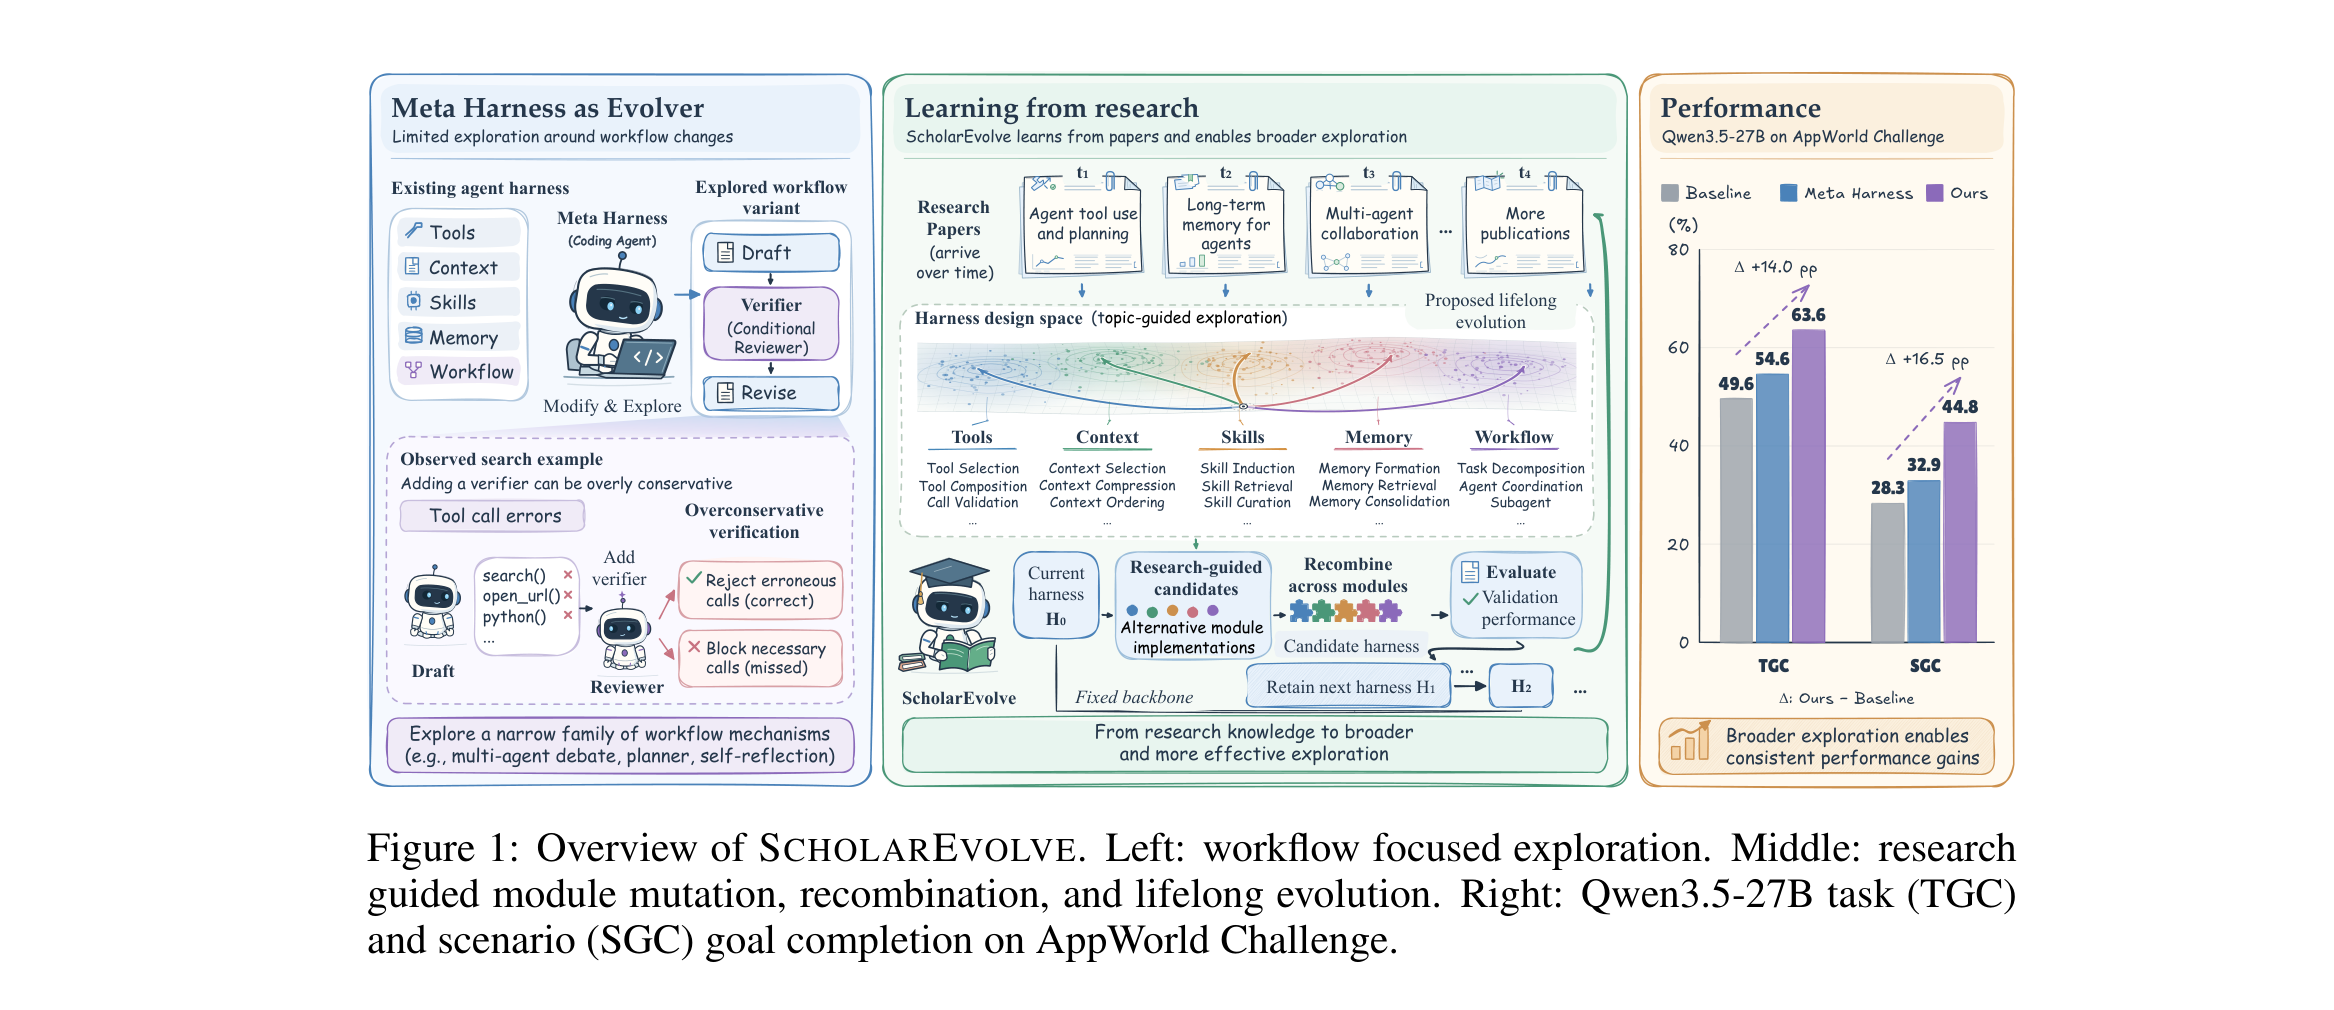
[논문 리뷰] Learning from Research: Toward Lifelong Agent Harness Evolution
문헌 기반 topic 탐색과 모듈 재조합으로 모델 가중치 없이 하네스를 개선하는 ScholarEvolve의 방법, 실험, 한계.
-
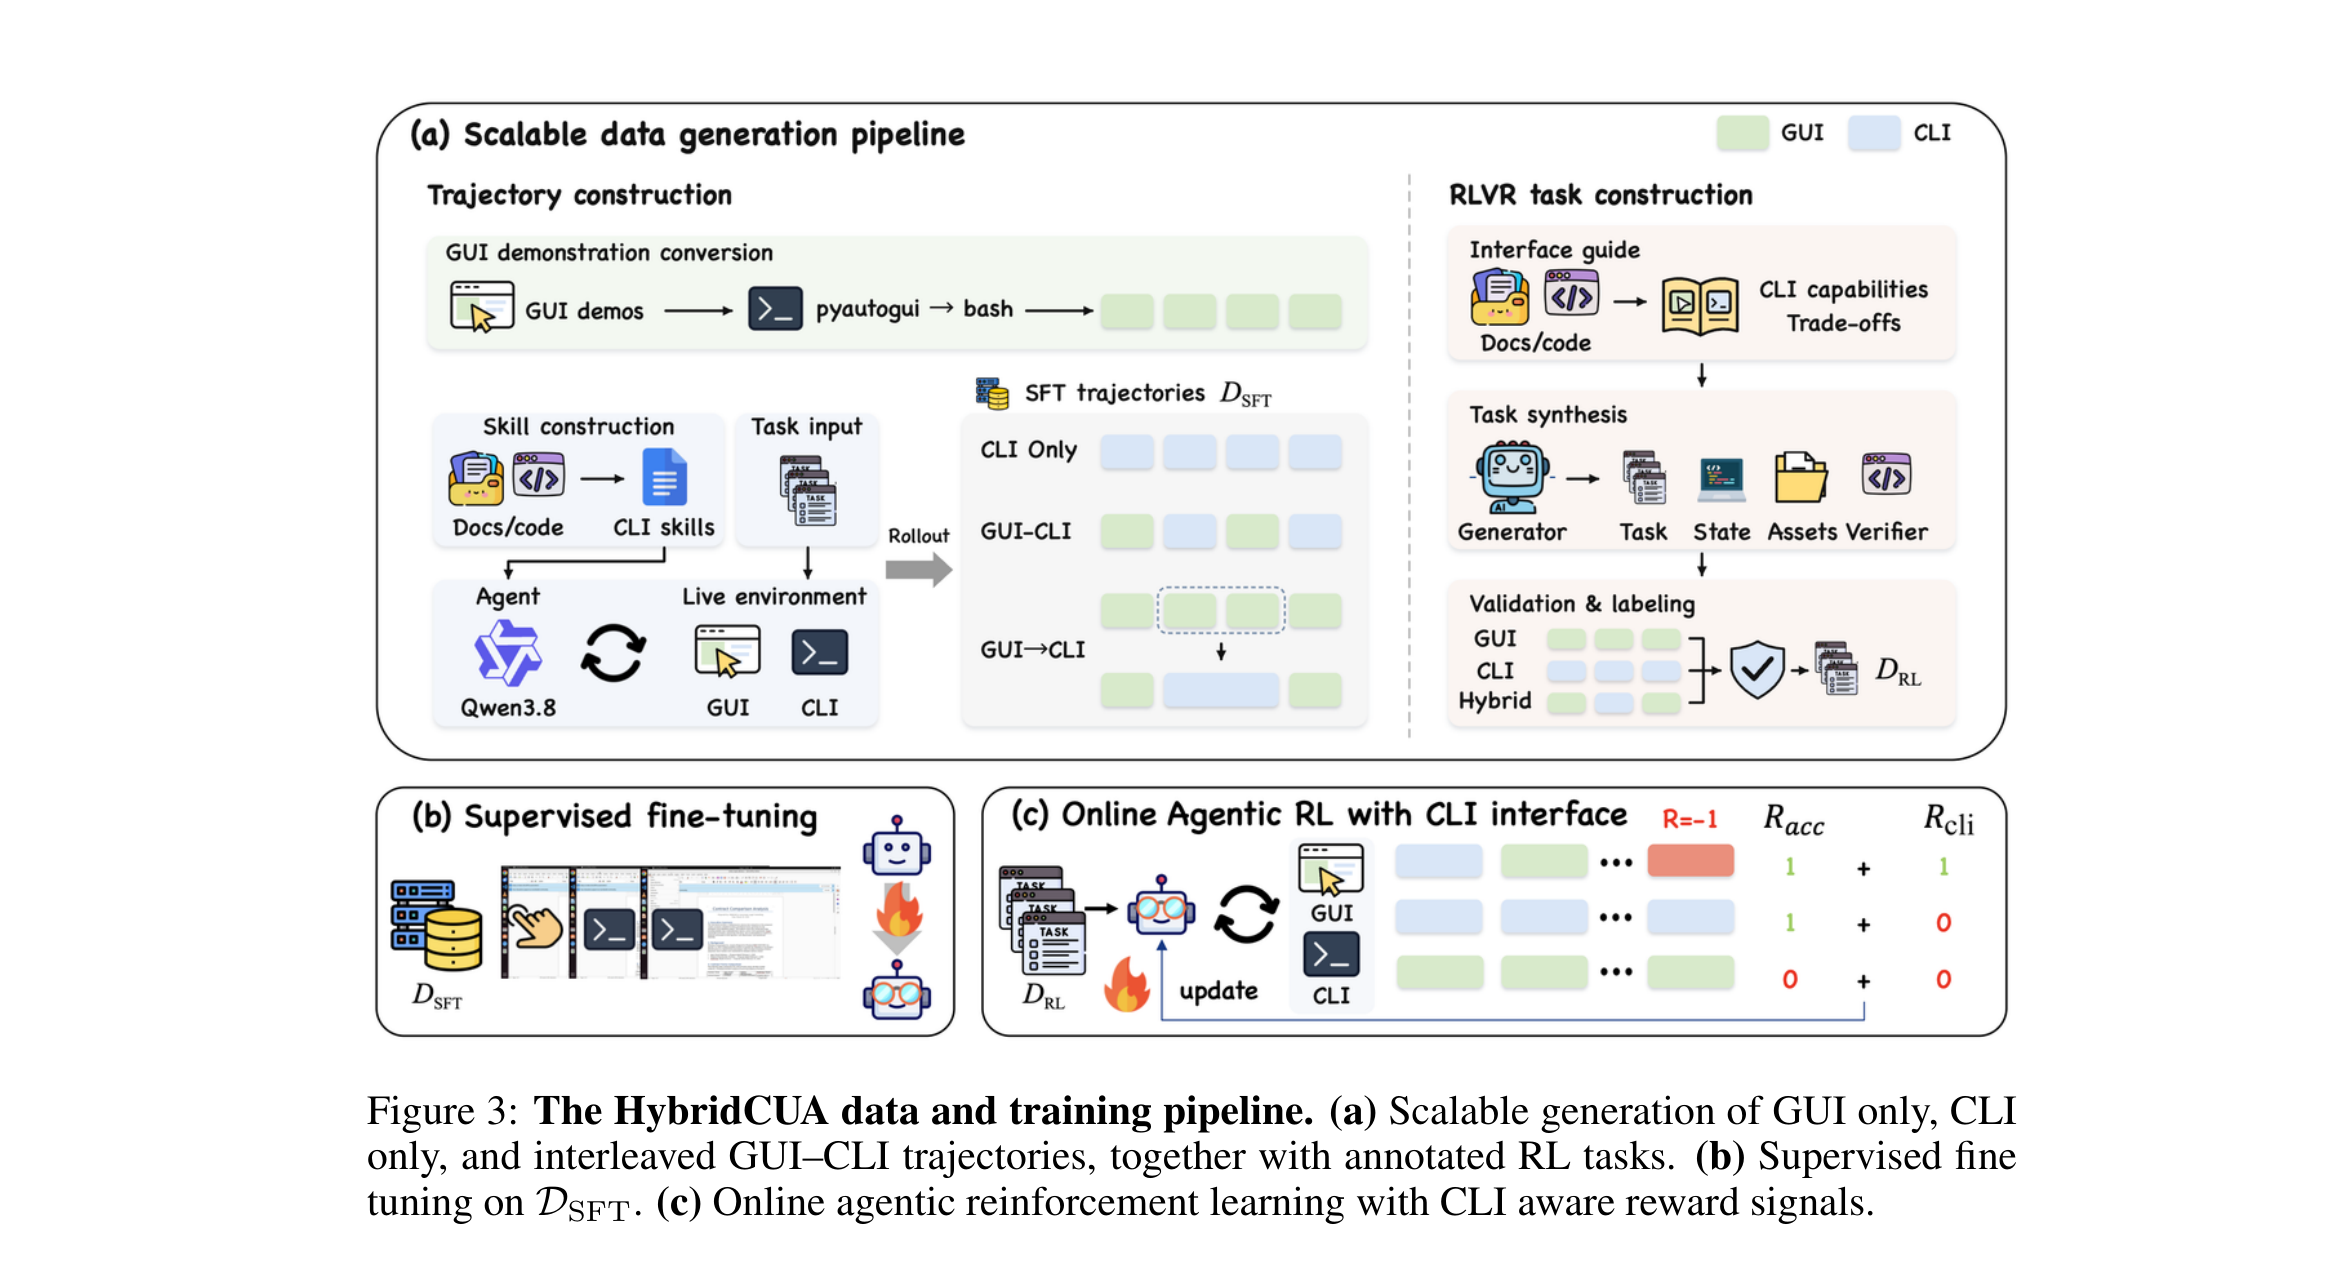
[논문 리뷰] HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
GUI와 CLI의 선택을 학습하는 HybridCUA: 혼합 trajectory, task별 인터페이스 보상, 명령 실행 오류의 단계별 교정
-
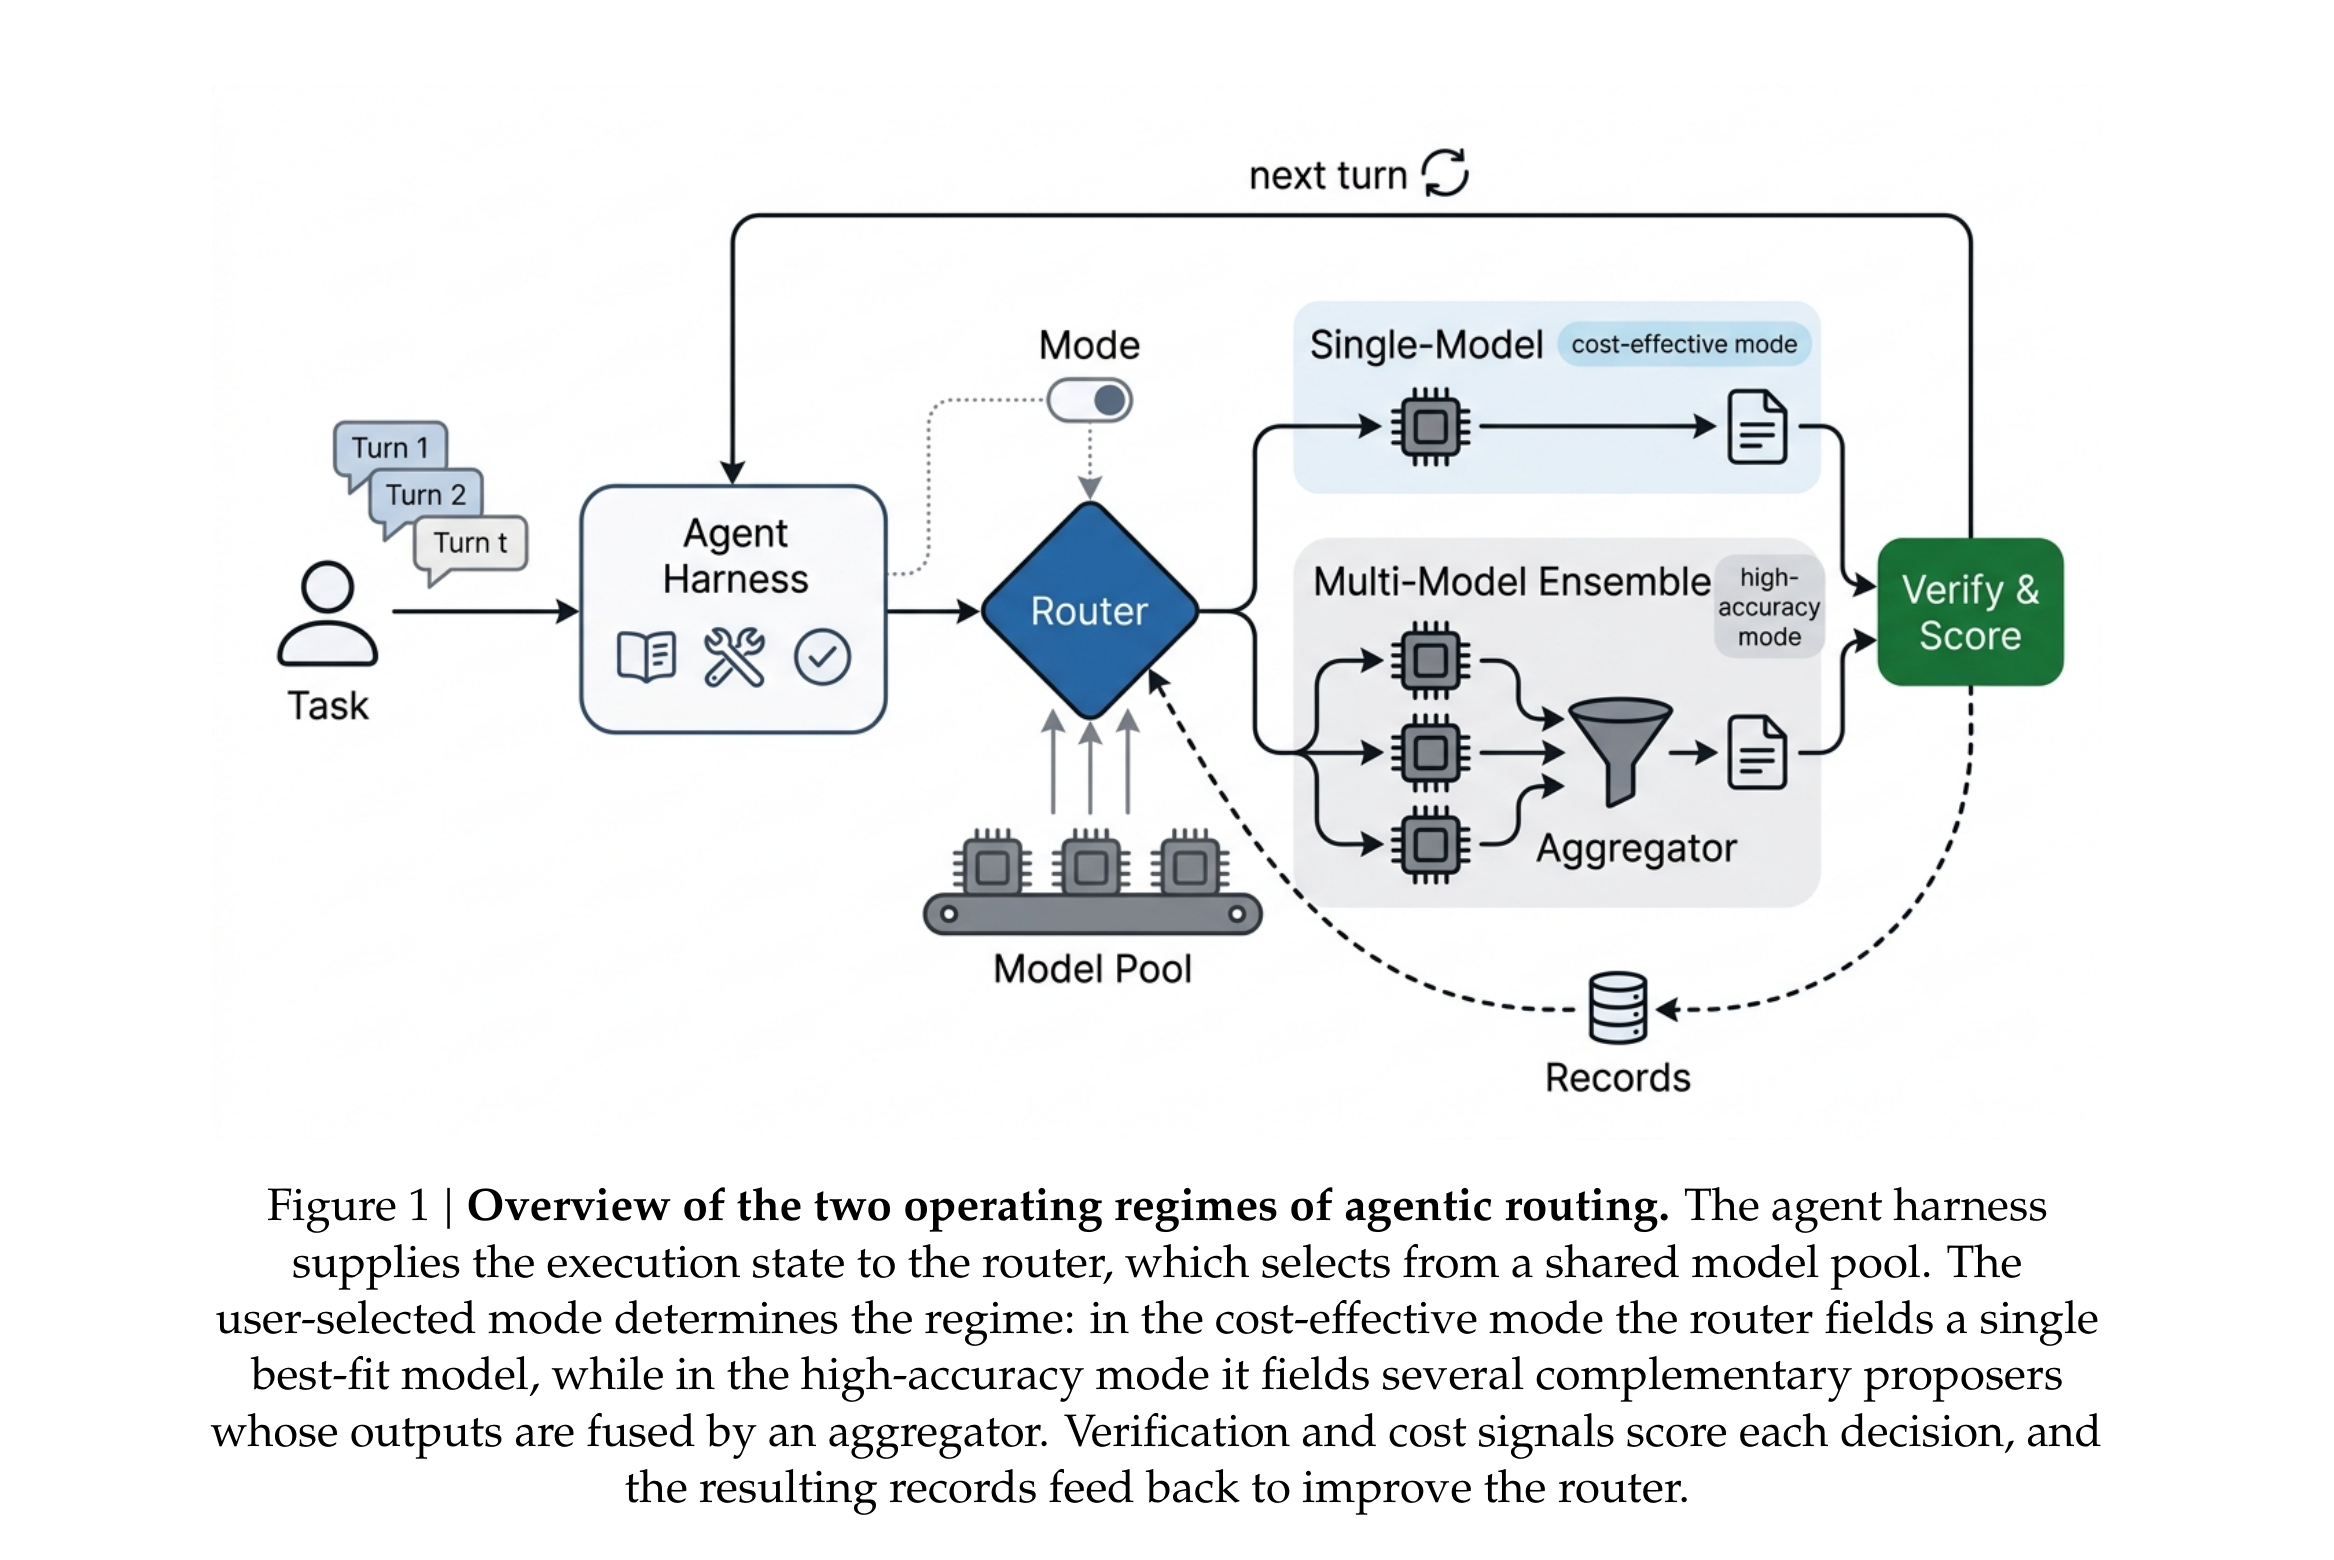
[논문 리뷰] Agentic Routing: The Harness-Native Data Flywheel
실행 상태에 따라 모델을 배정하는 OpenSquilla: 비용·품질·지연 시간의 실험과 라우팅 기록의 학습 데이터 활용
-
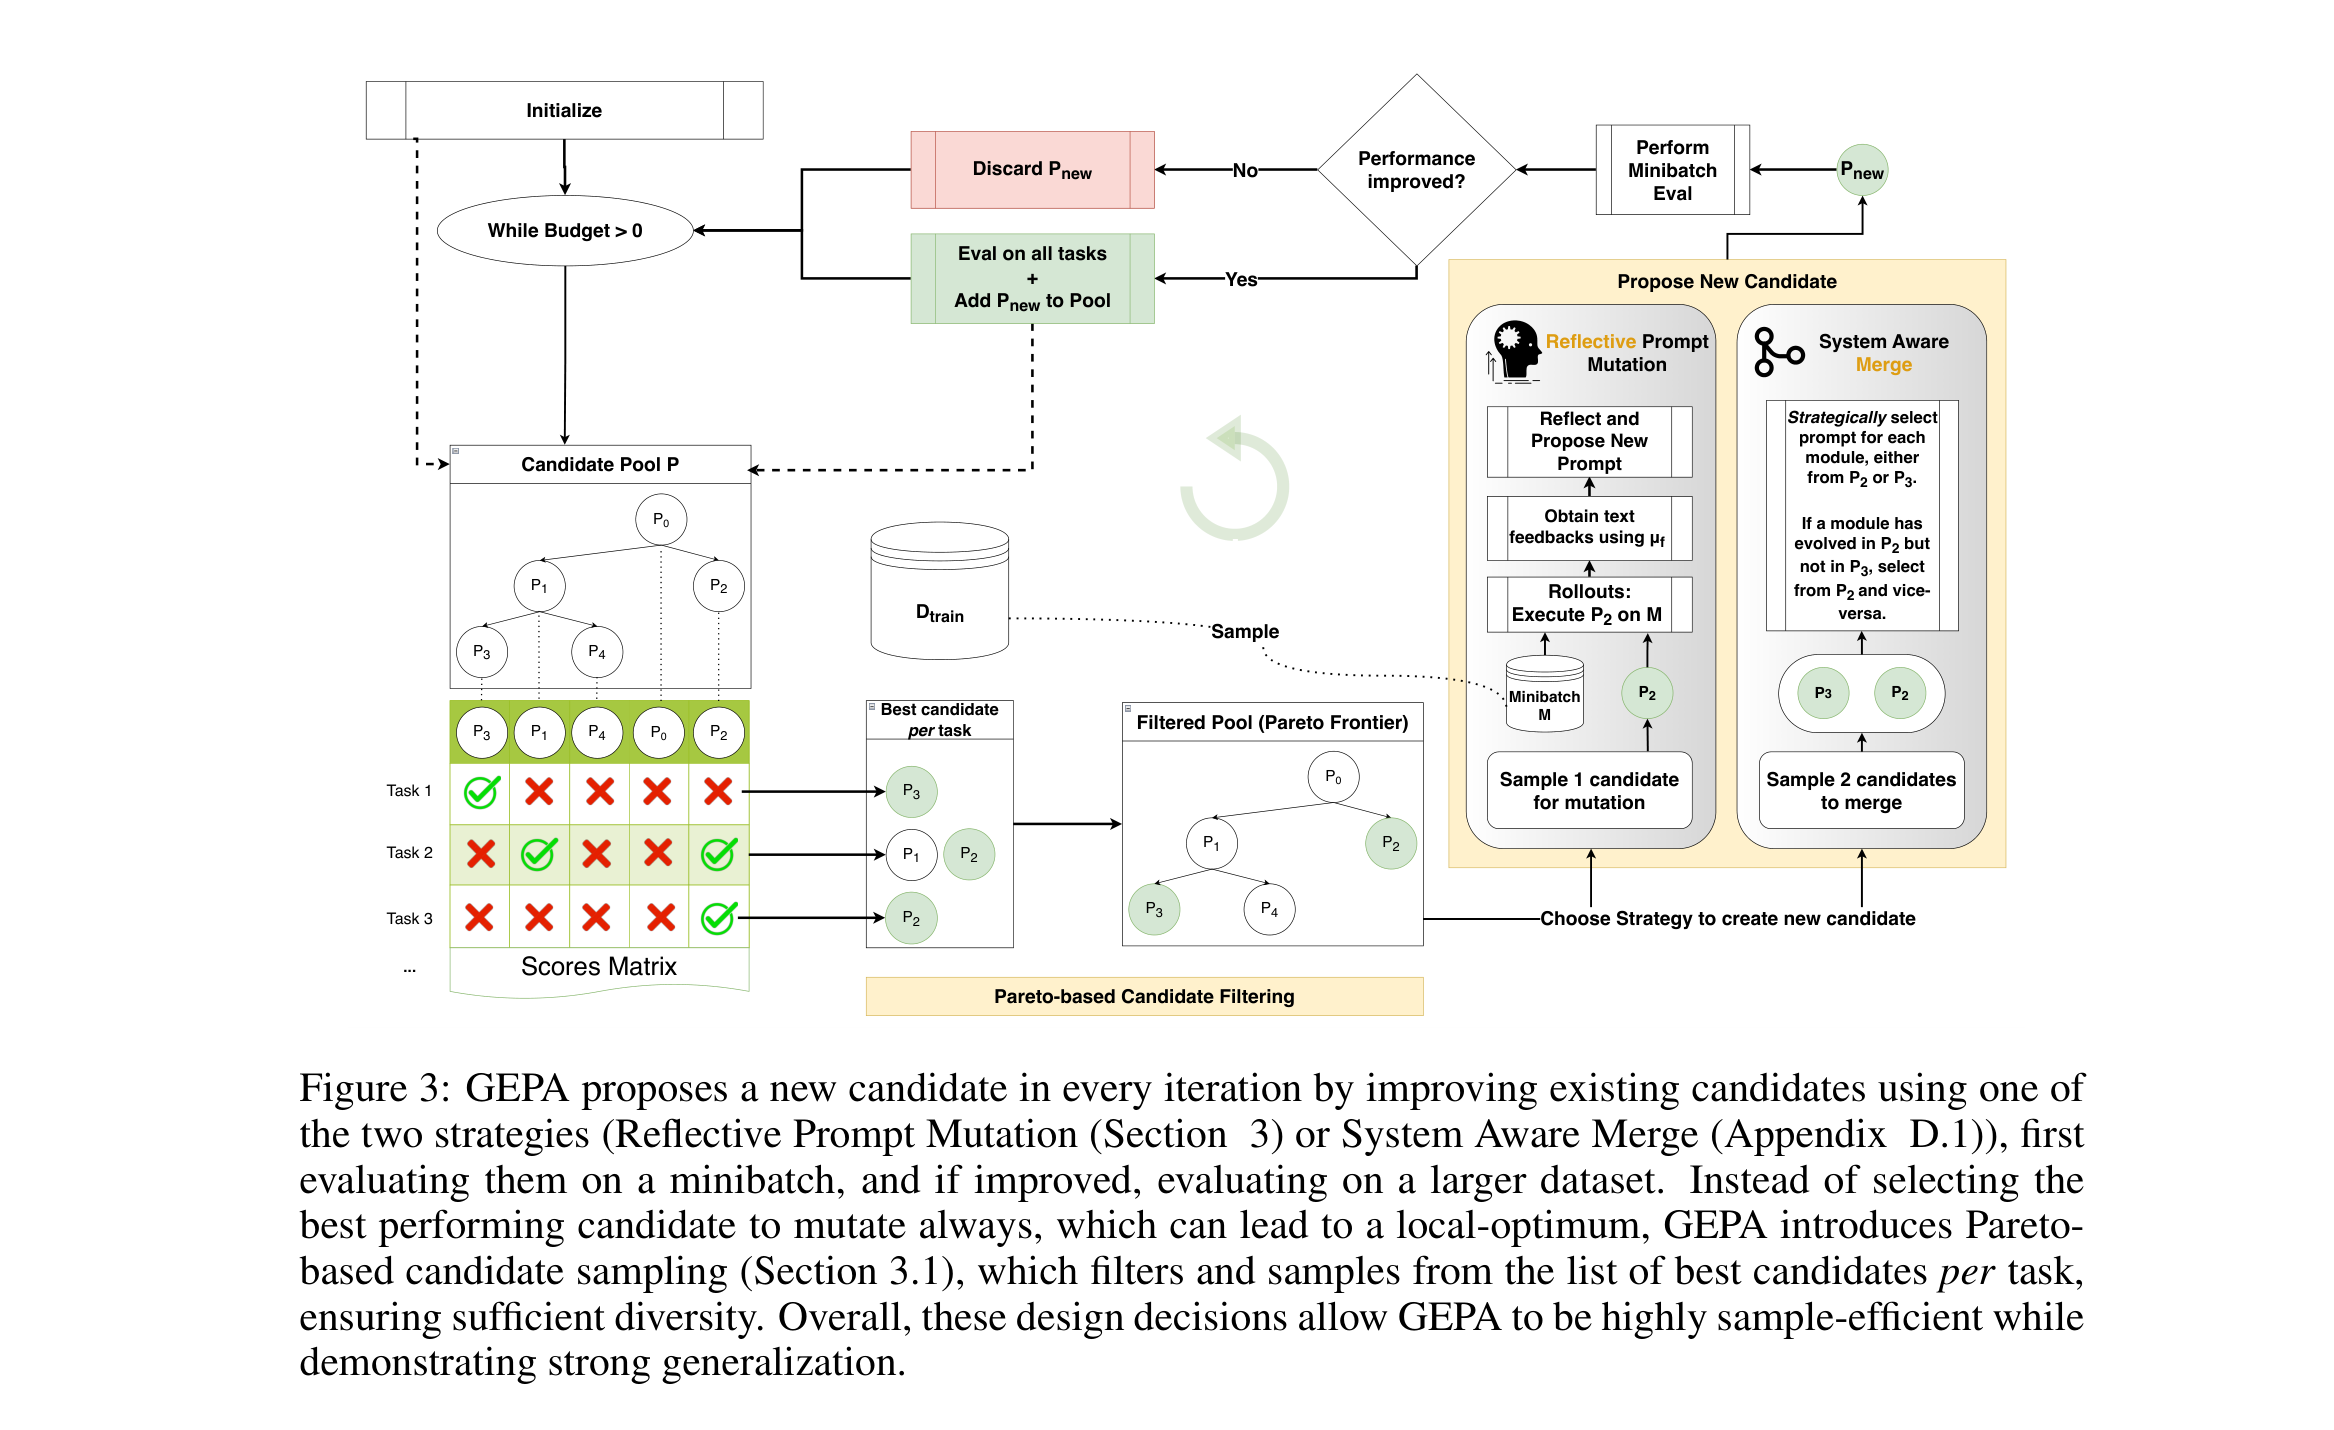
[논문 리뷰] GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning
실행 trace를 읽는 reflection과 instance별 Pareto 탐색으로 프롬프트를 개선하는 GEPA의 구조, GRPO 비교, rollout 비용과 일반화 한계.
-
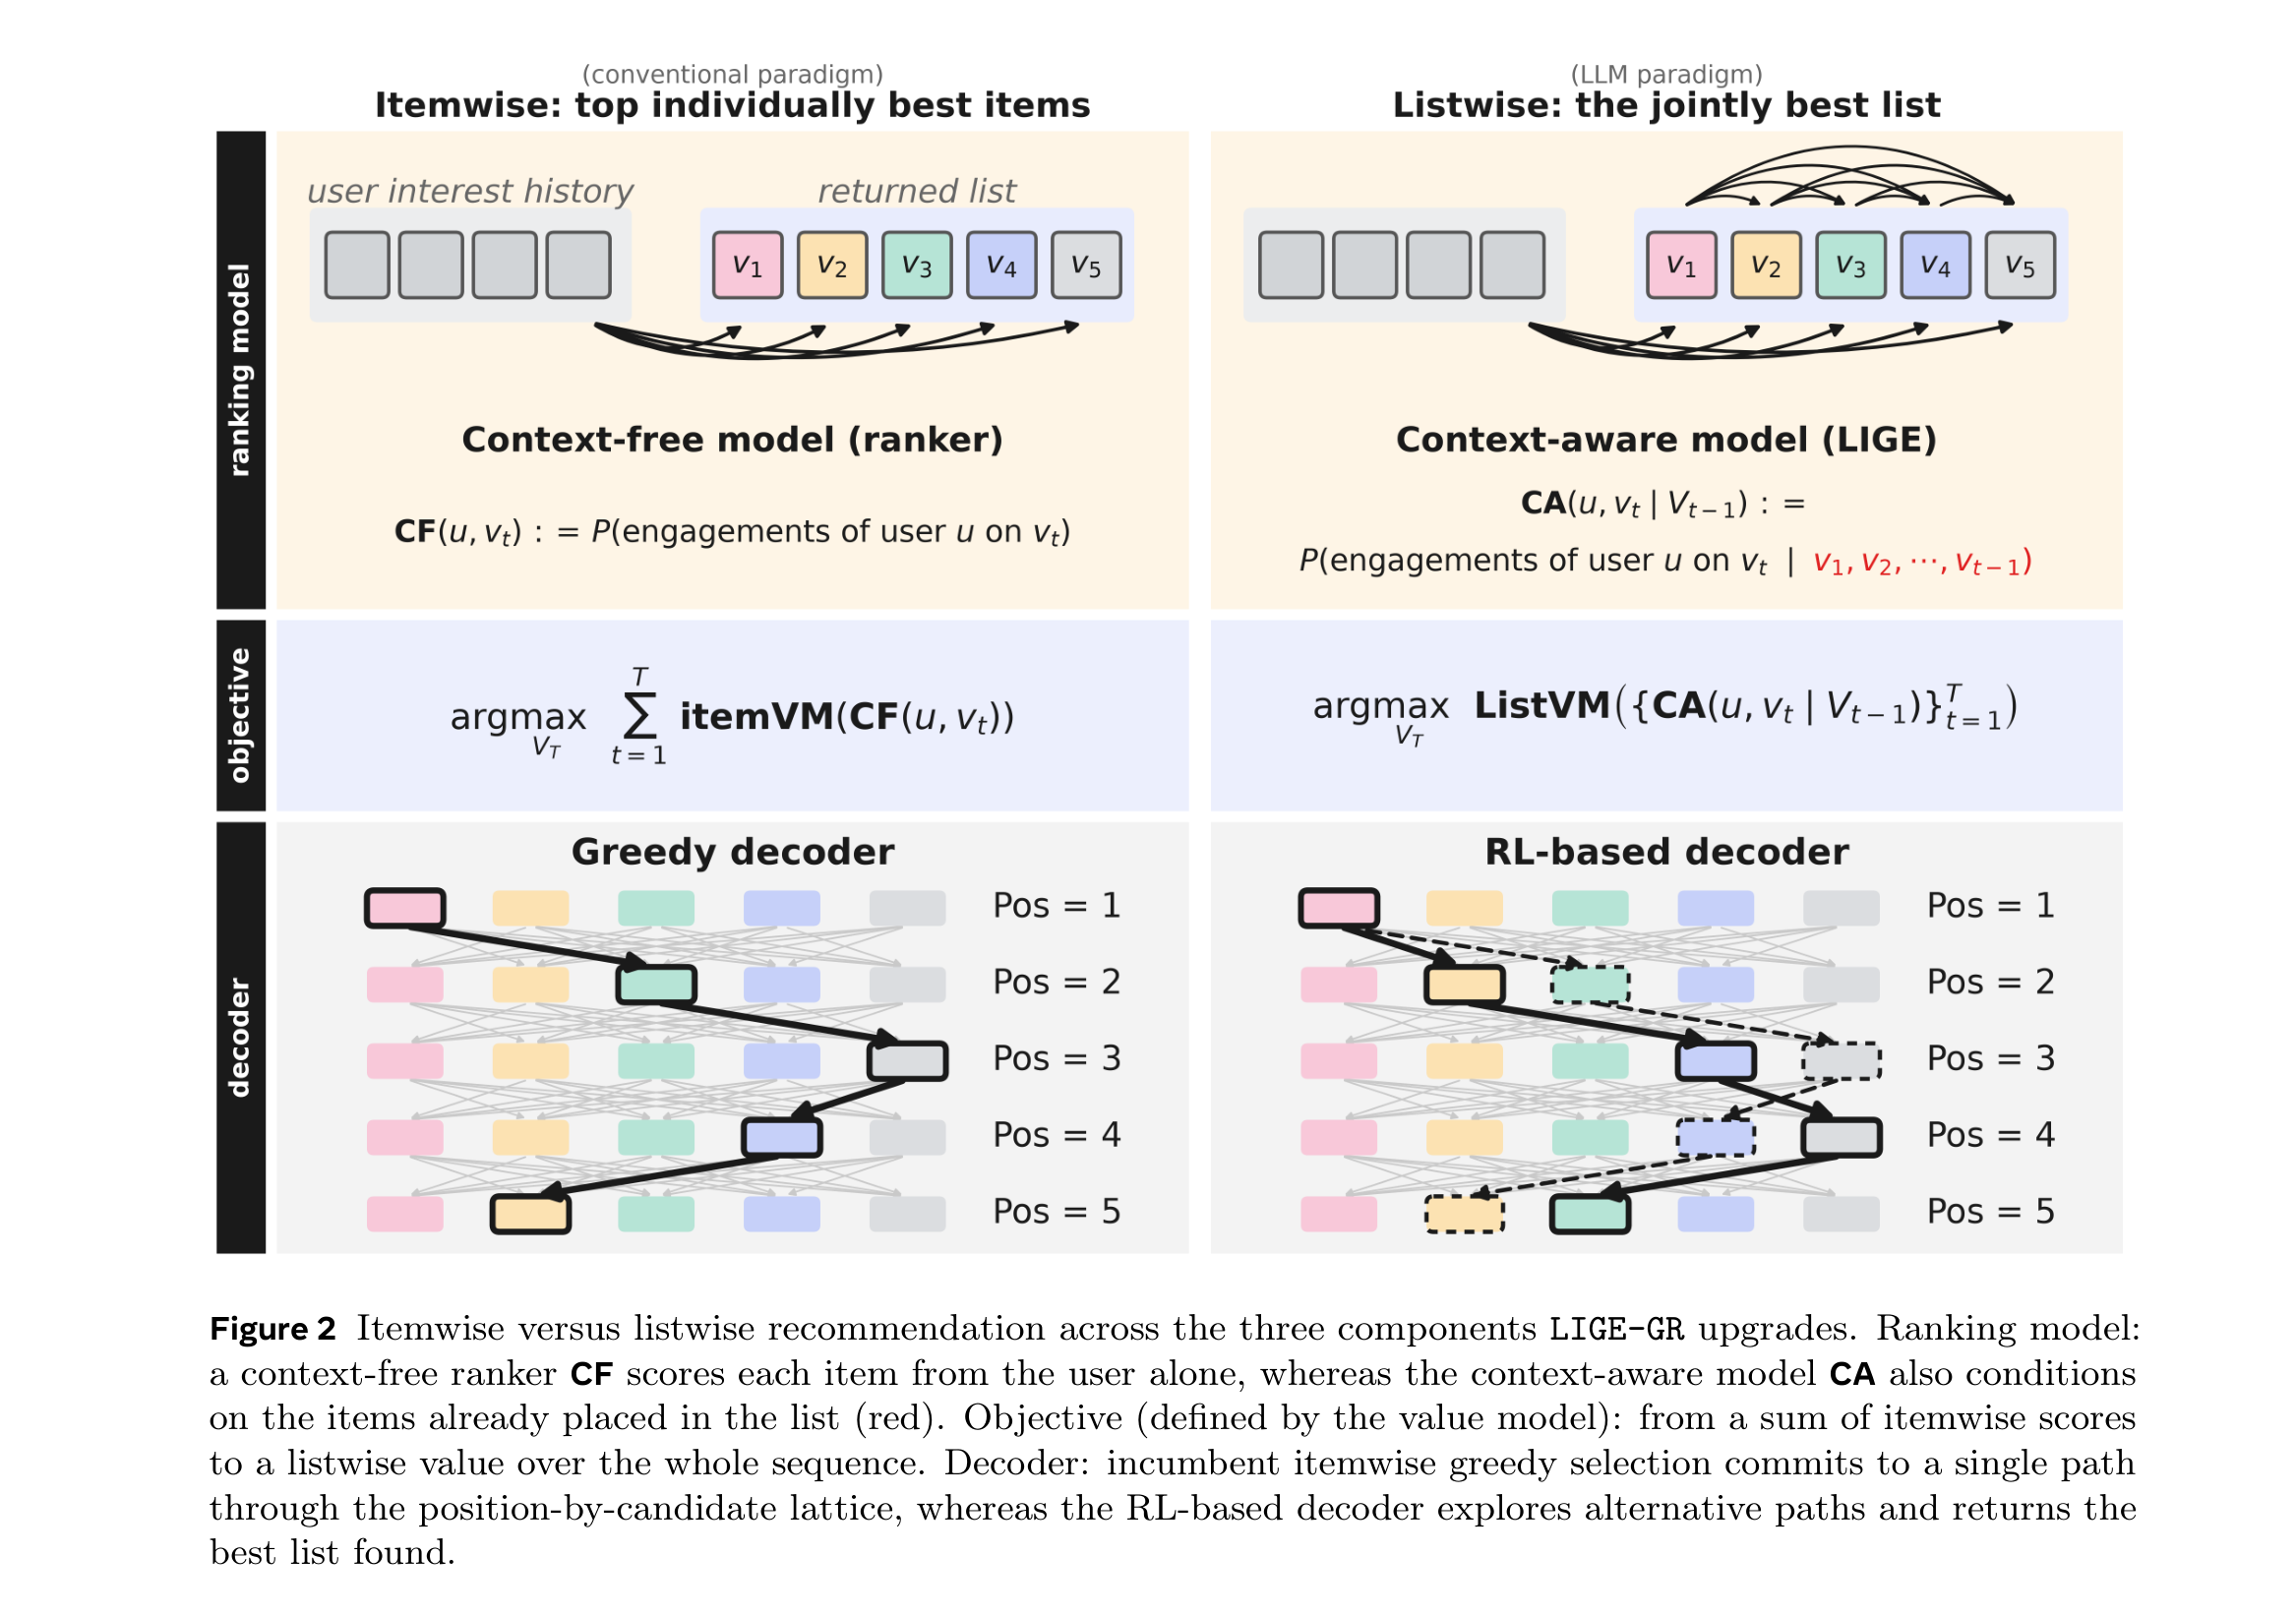
[논문 리뷰] LIGE-GR: A Smooth Leap from Ranking to Generative Recommendation in the LLM Era
기존 ranking을 보존하는 LIGE-GR의 context-aware 예측, continuation 기반 목록 가치, Palette 탐색과 Meta의 온라인 실험.
-
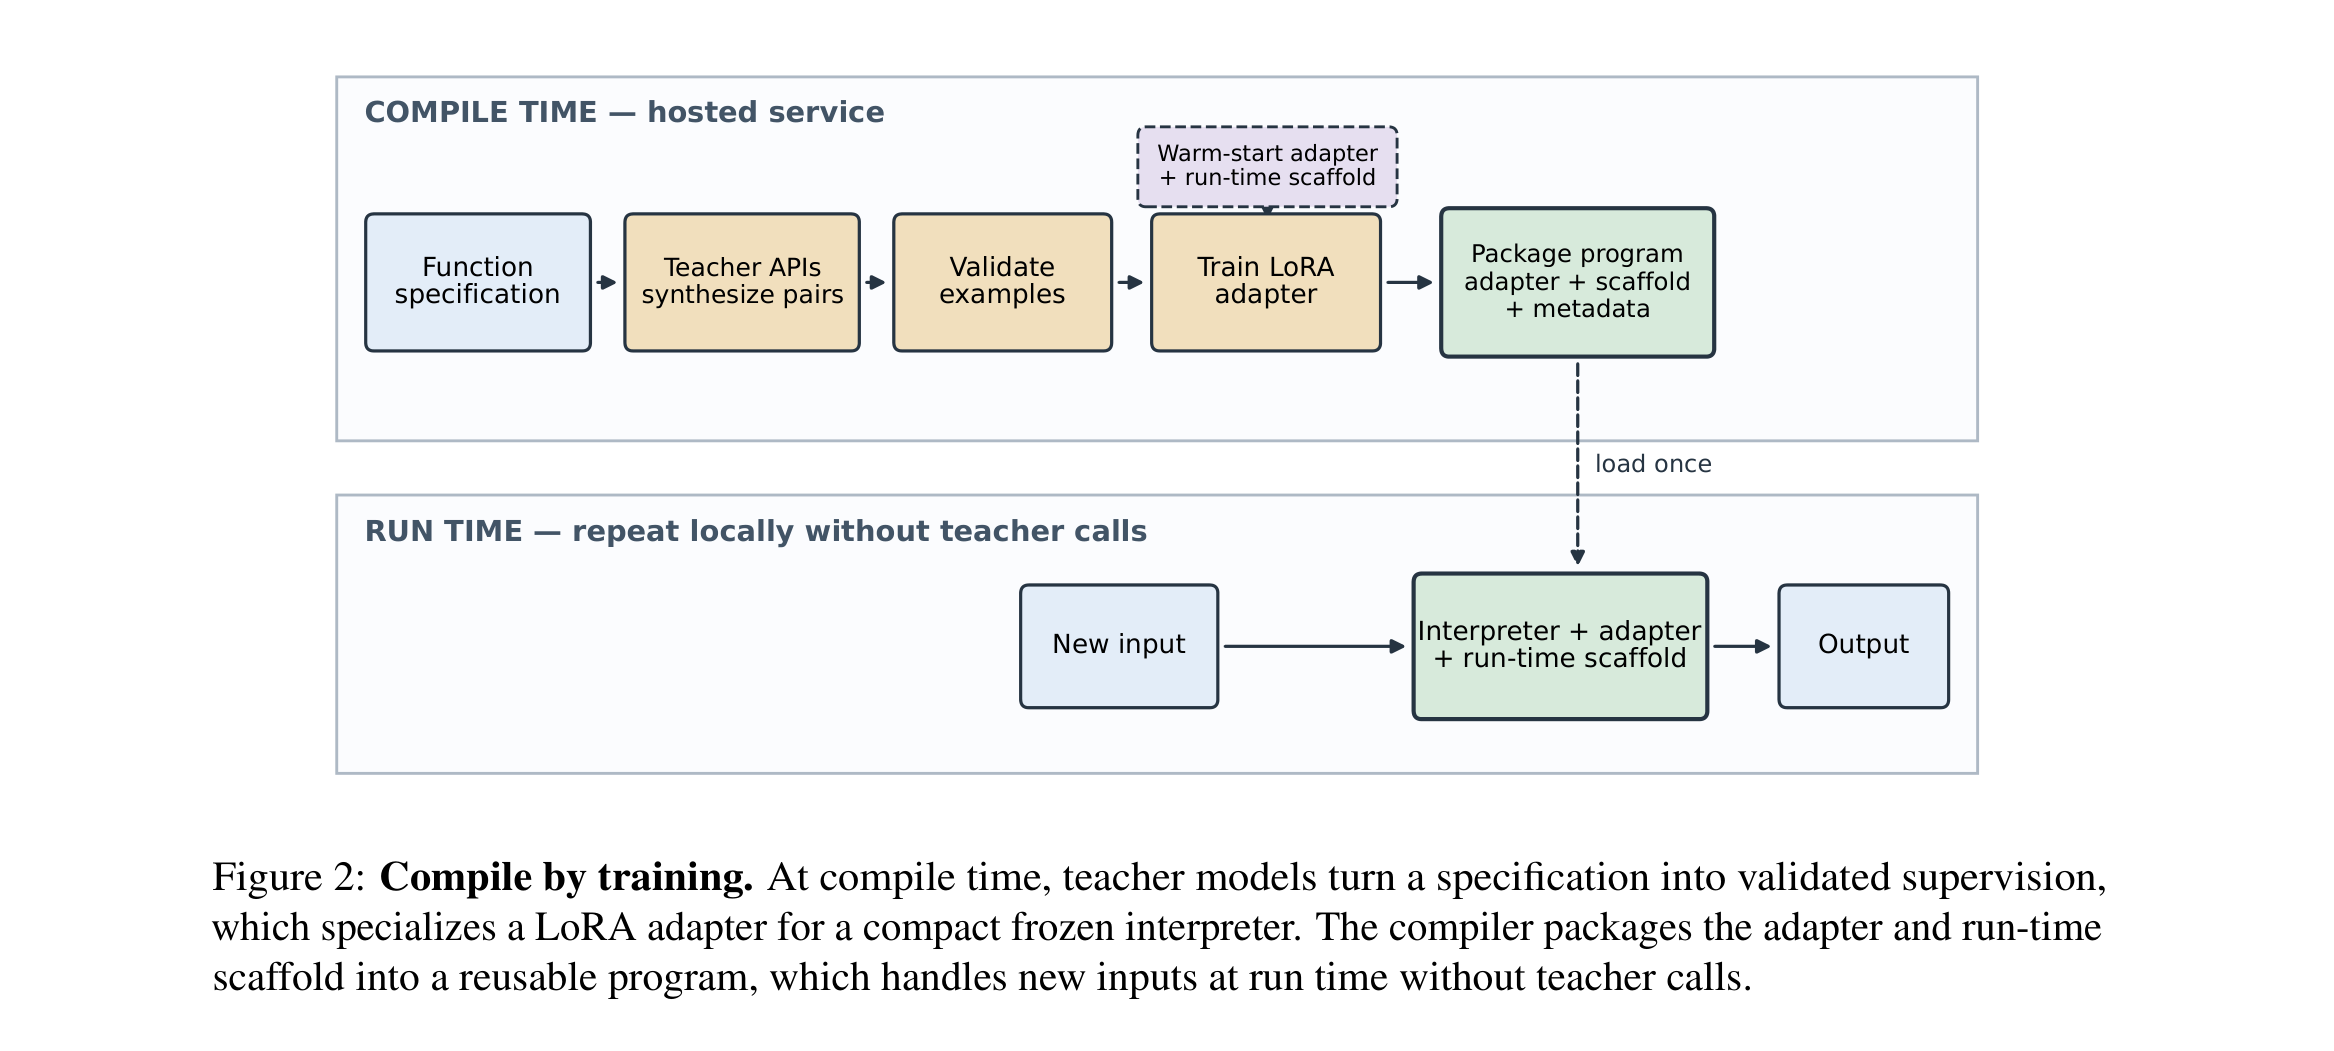
[논문 리뷰] Compile by Training: Turning Natural-Language Specifications into Local Neural Functions
자연어 명세를 Qwen3-0.6B의 LoRA 함수로 컴파일하는 방법: FuzzyBench-Hard 83.6%의 평가 조건, 합성 데이터 실험, 비동기 학습과 로컬 실행의 한계.
-
[논문 리뷰] Procedural Graphs: Self-Evolving Execution Structures for LLM Agents
Procedural Graph의 단계별 안내와 검증 기반 그래프 진화: 7개 벤치마크의 성능, 추가 토큰 비용, 잘못된 절차의 수정과 일반화 한계 분석.