-
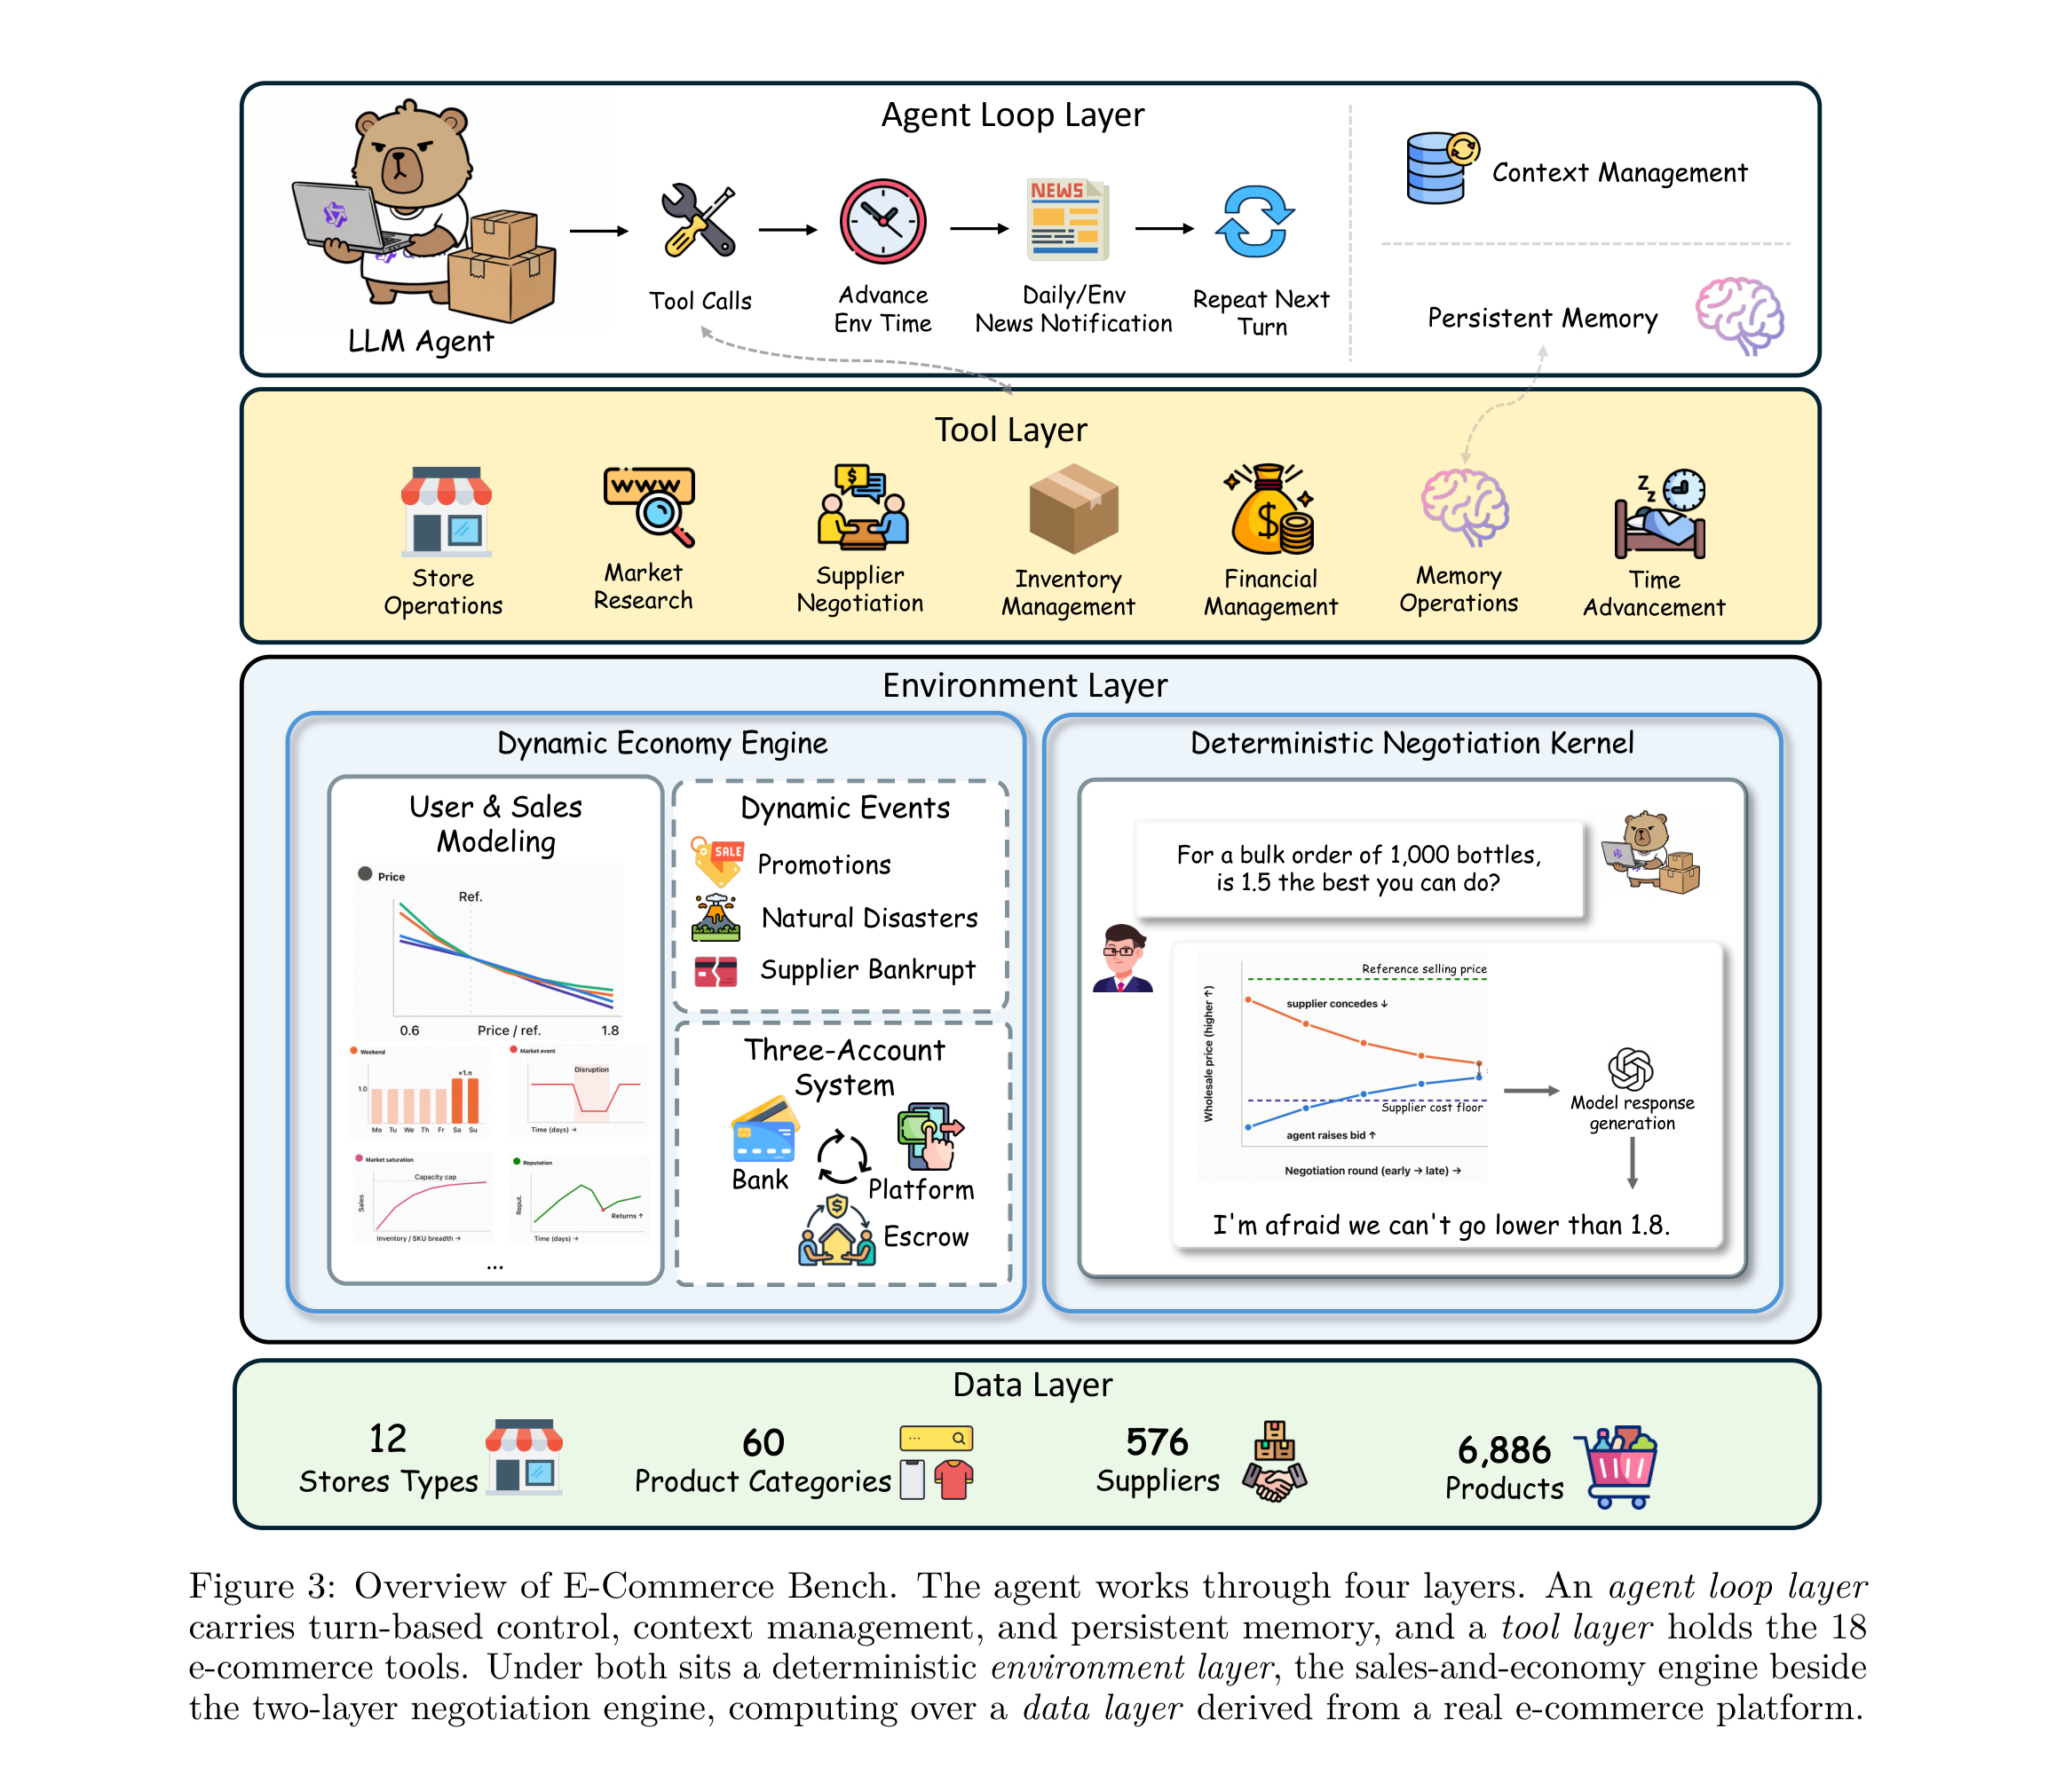
[논문 리뷰] E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation
365일의 상점 운영으로 살펴본 LLM agent의 수익, 현금 흐름, 사기 대응과 경험 활용: E-Commerce Bench의 환경 설계와 18개 모델 평가.
-
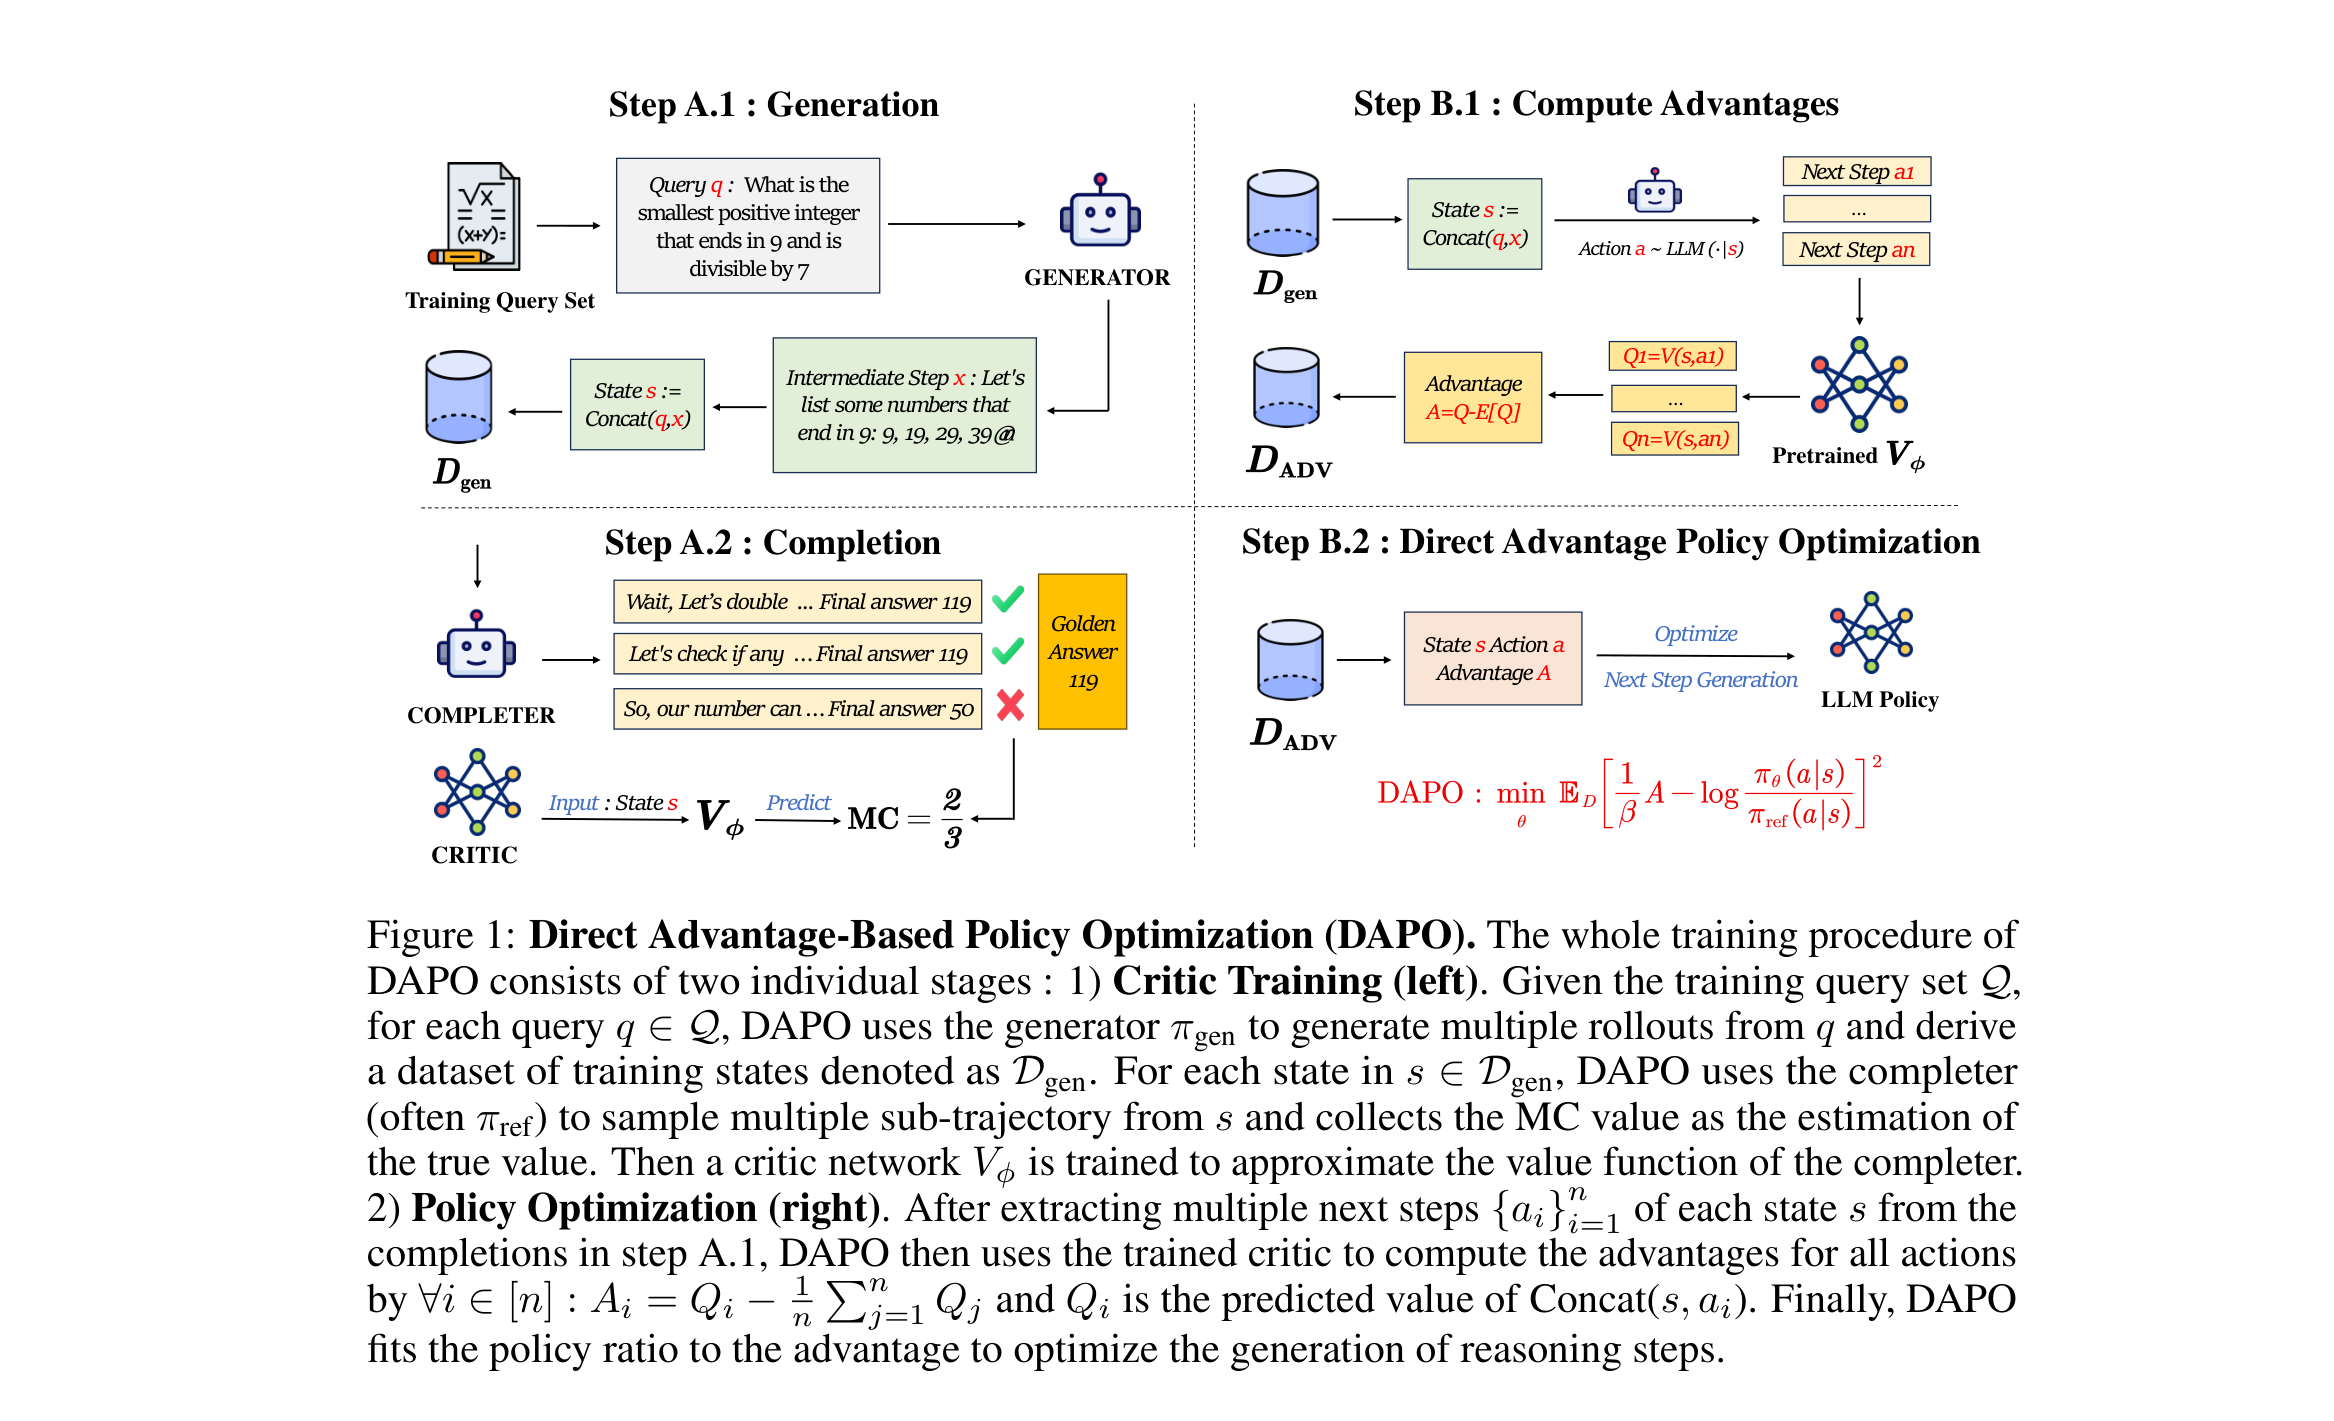
[논문 리뷰] DAPO: Improving Multi-Step Reasoning Abilities of Large Language Models with Direct Advantage-Based Policy Optimization
단계별 advantage와 정책 log-ratio를 맞추는 offline RL: DAPO의 critic 학습, 단조 개선 정리의 조건, 수학·코드 실험과 계산 비용 분석.
-
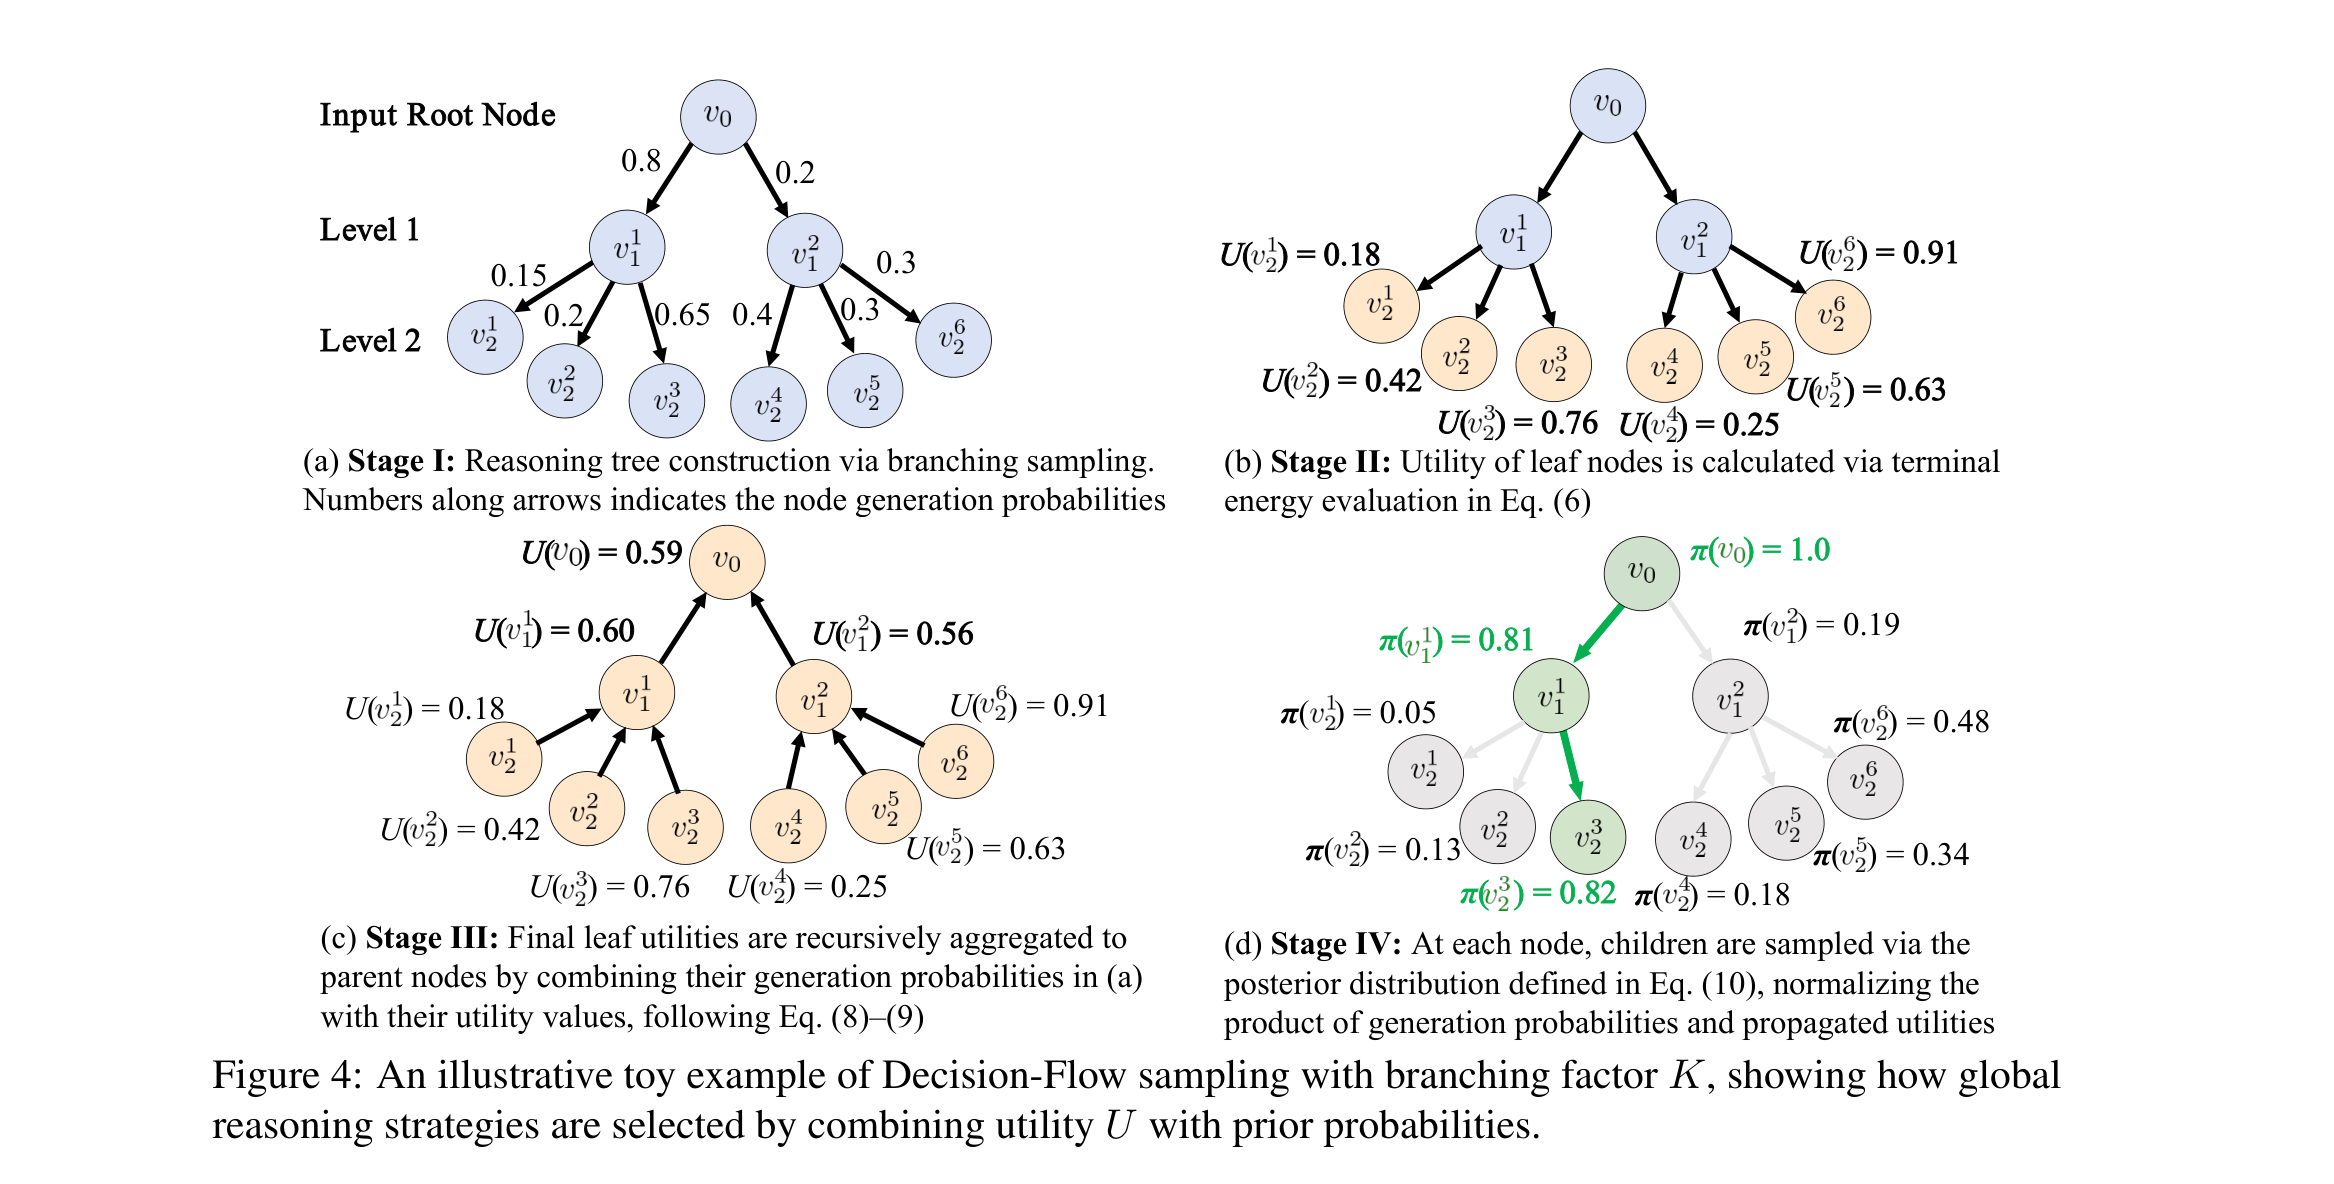
[논문 리뷰] Sampling via Decision-Flow: Training-Free Extraction of Improved Latent Reasoning Paths in Large Language Models
DF-Sample의 추론 트리·말단 평가·효용 역전파의 작동 원리와 GPT-4o 의존성, 벤치마크별 예외, 탐색 비용 분석.
-
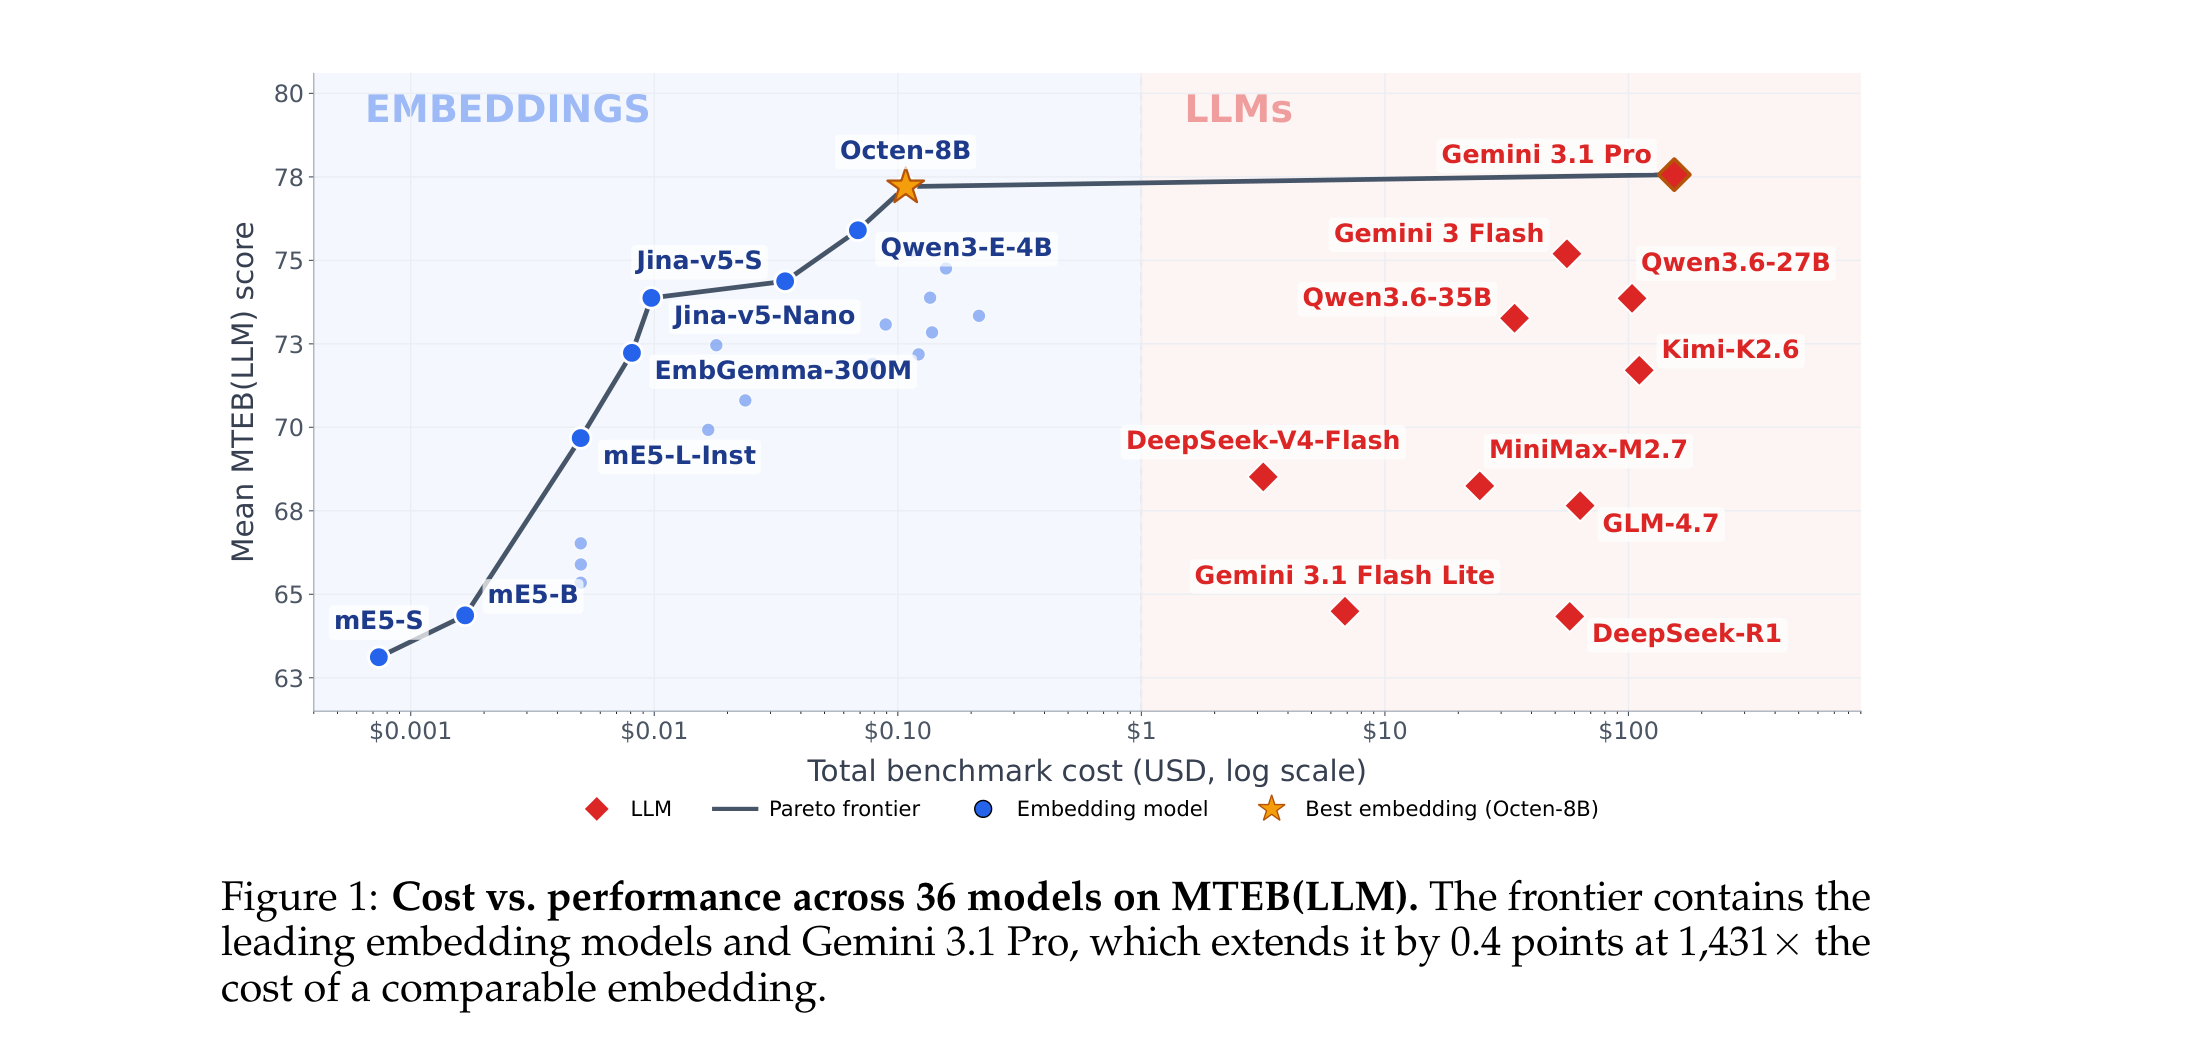
[논문 리뷰] The Embedder's Dilemma: LLMs Are Better, but at What Cost?
MTEB(LLM)의 품질·비용 및 재순위화 결과 비교. 감독 정보·추론 예산·집계 지표의 한계 분석.
-
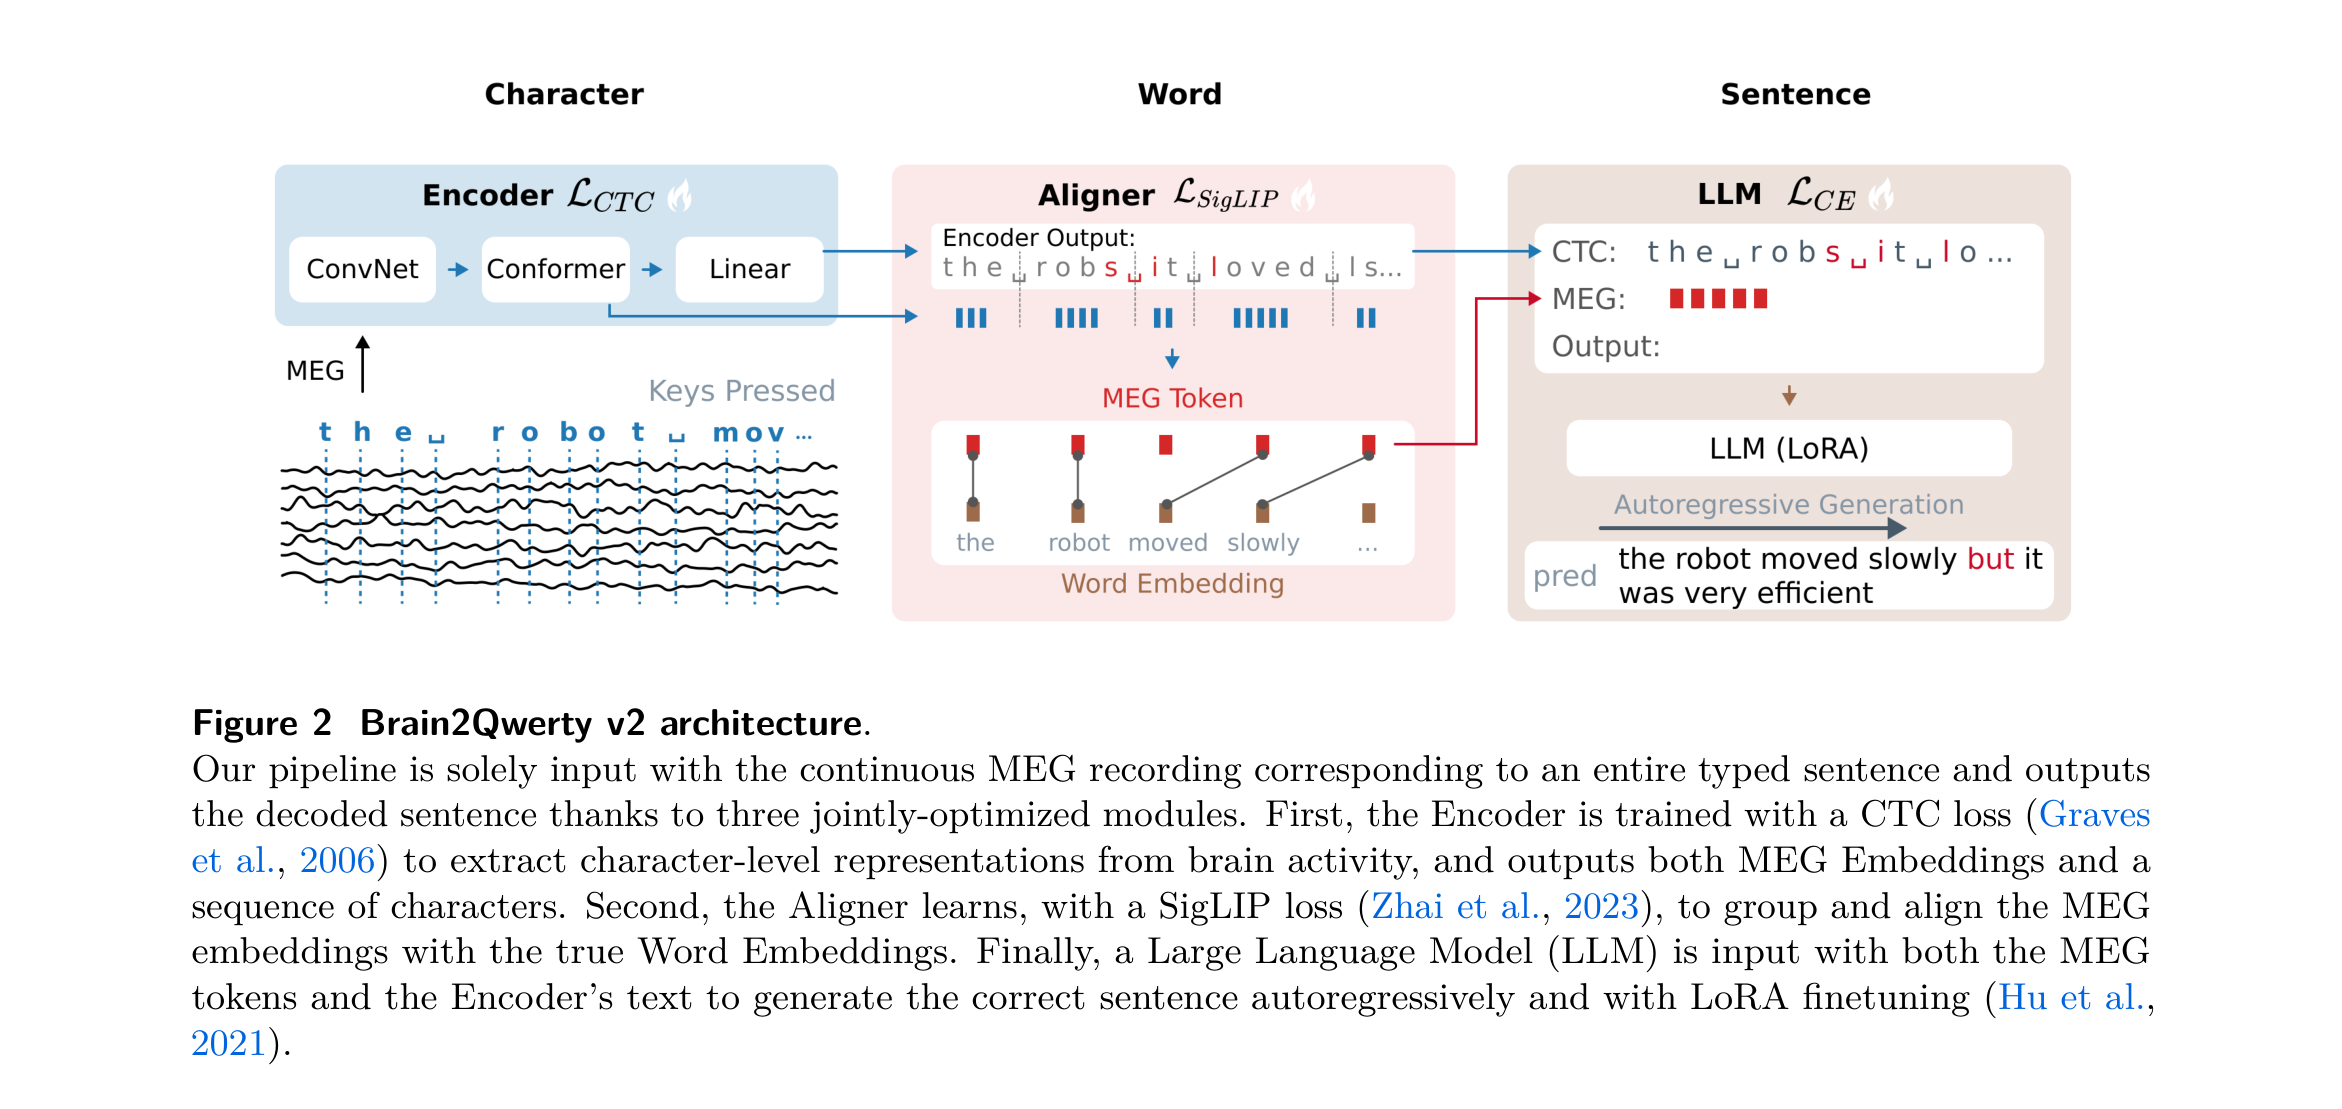
[논문 리뷰] Accurate Decoding of Natural Sentences from Non-Invasive Brain Recordings
9명에게서 90시간·2,724 문장의 MEG 를 모으고, CTC 인코더 · 단어 정렬기 · LoRA LLM 을 한 파이프라인으로 묶어 비침습 뇌 신호에서 자연 문장을 WER 39% 로 디코딩한 Meta AI 의 Brain2Qwerty v2
-
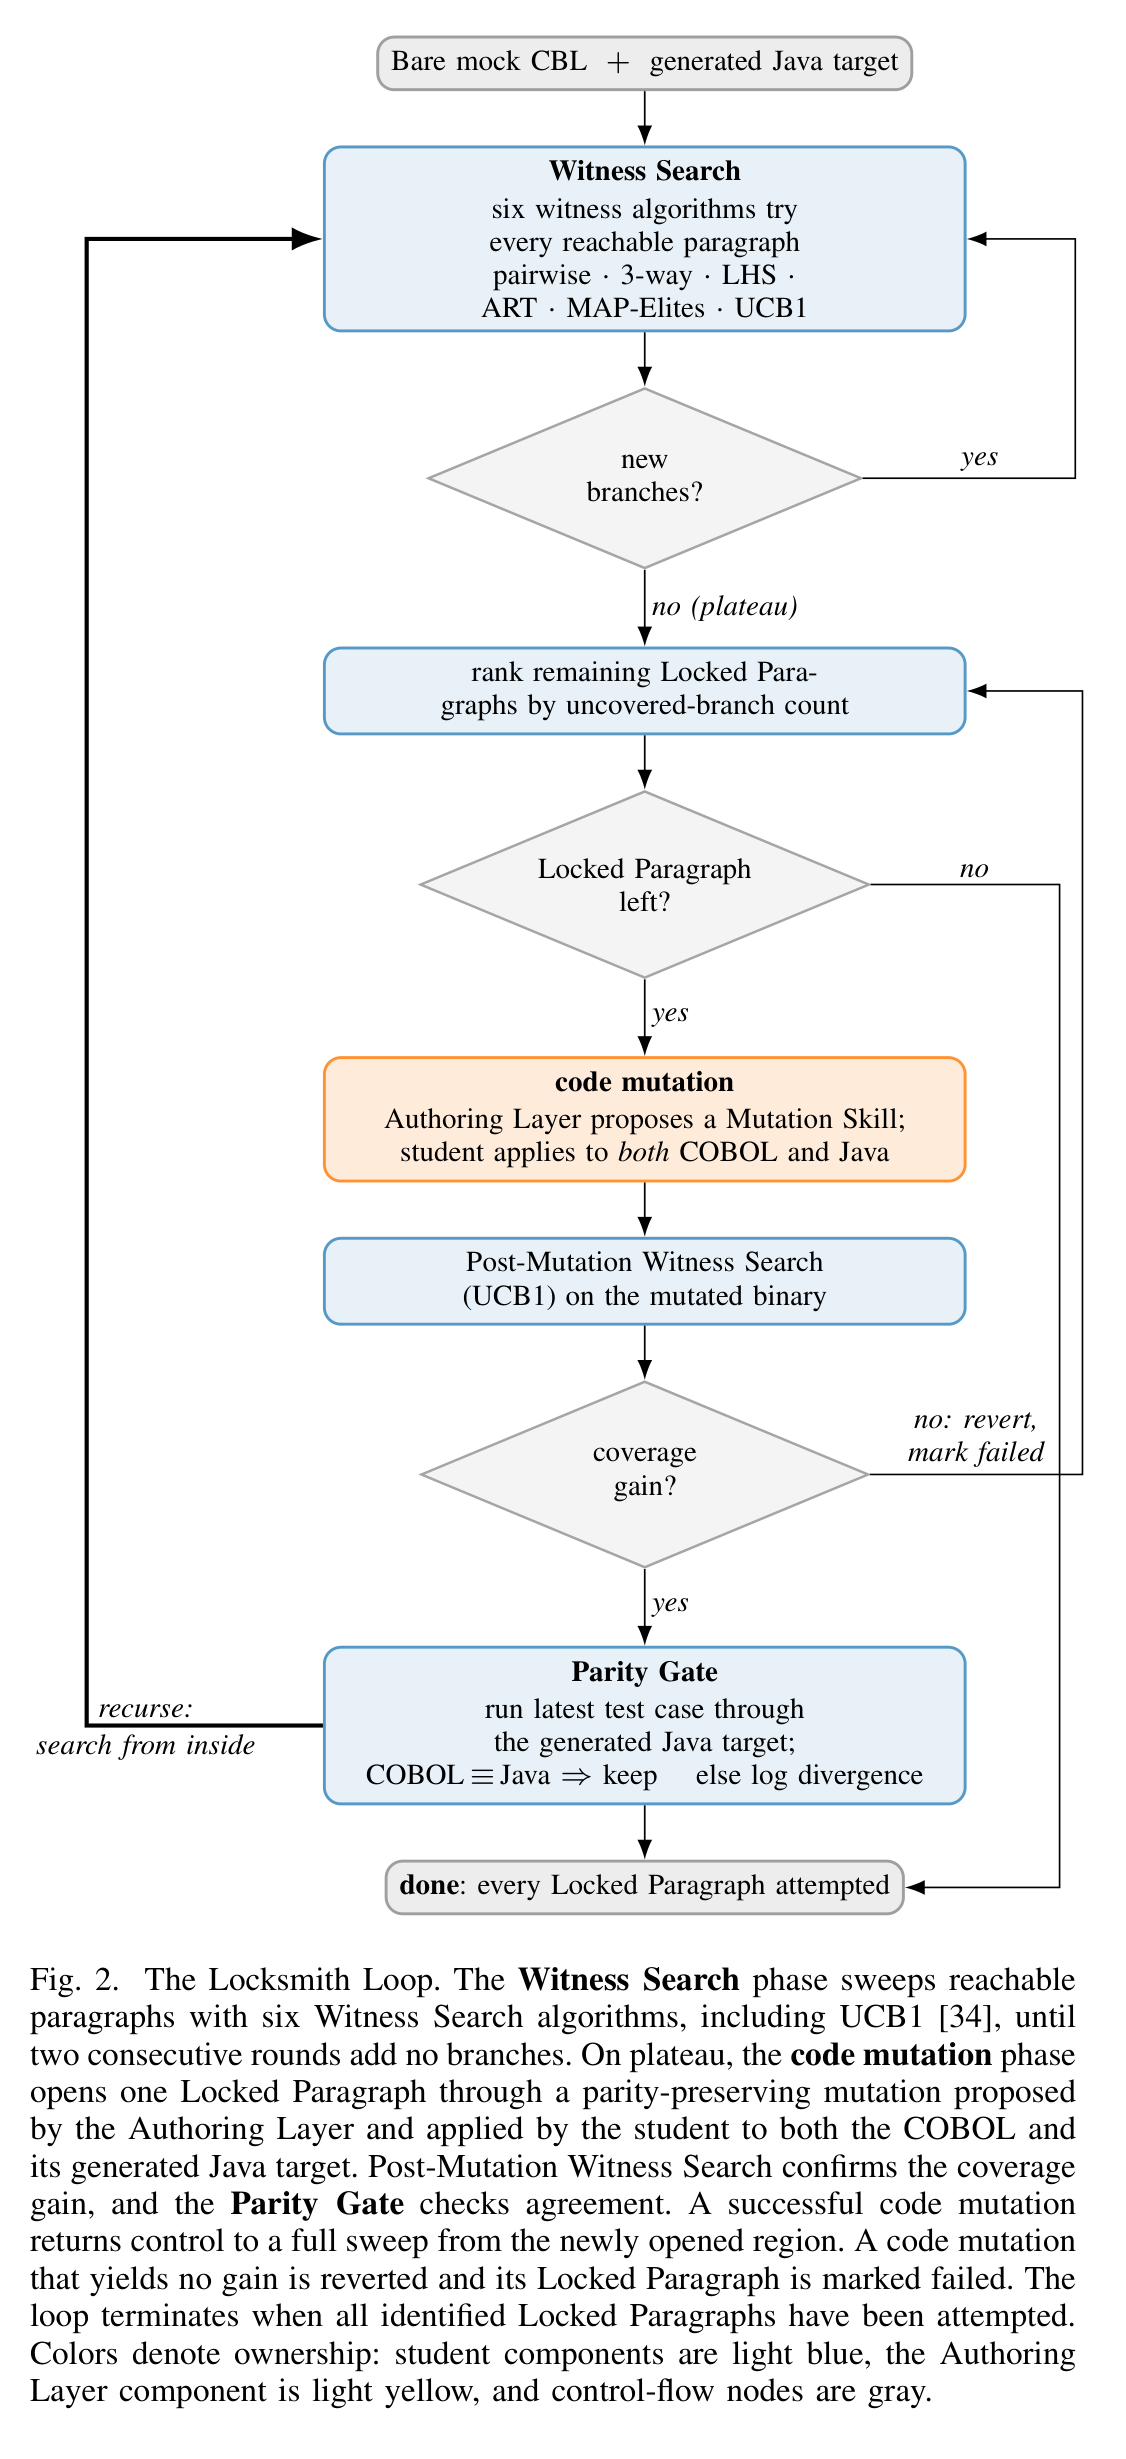
[논문 리뷰] Agentic Method for Deterministic Validation of Legacy Code Migration
COBOL→Java 마이그레이션 검증에서 입력 탐색이 막히면 하네스 자체를 변형해 새 실행 영역을 열고, 그 변형을 두 언어에 대칭 적용한 뒤 결정론적 parity 오라클로 판정하는 American Express 의 Locksmith Loop
-
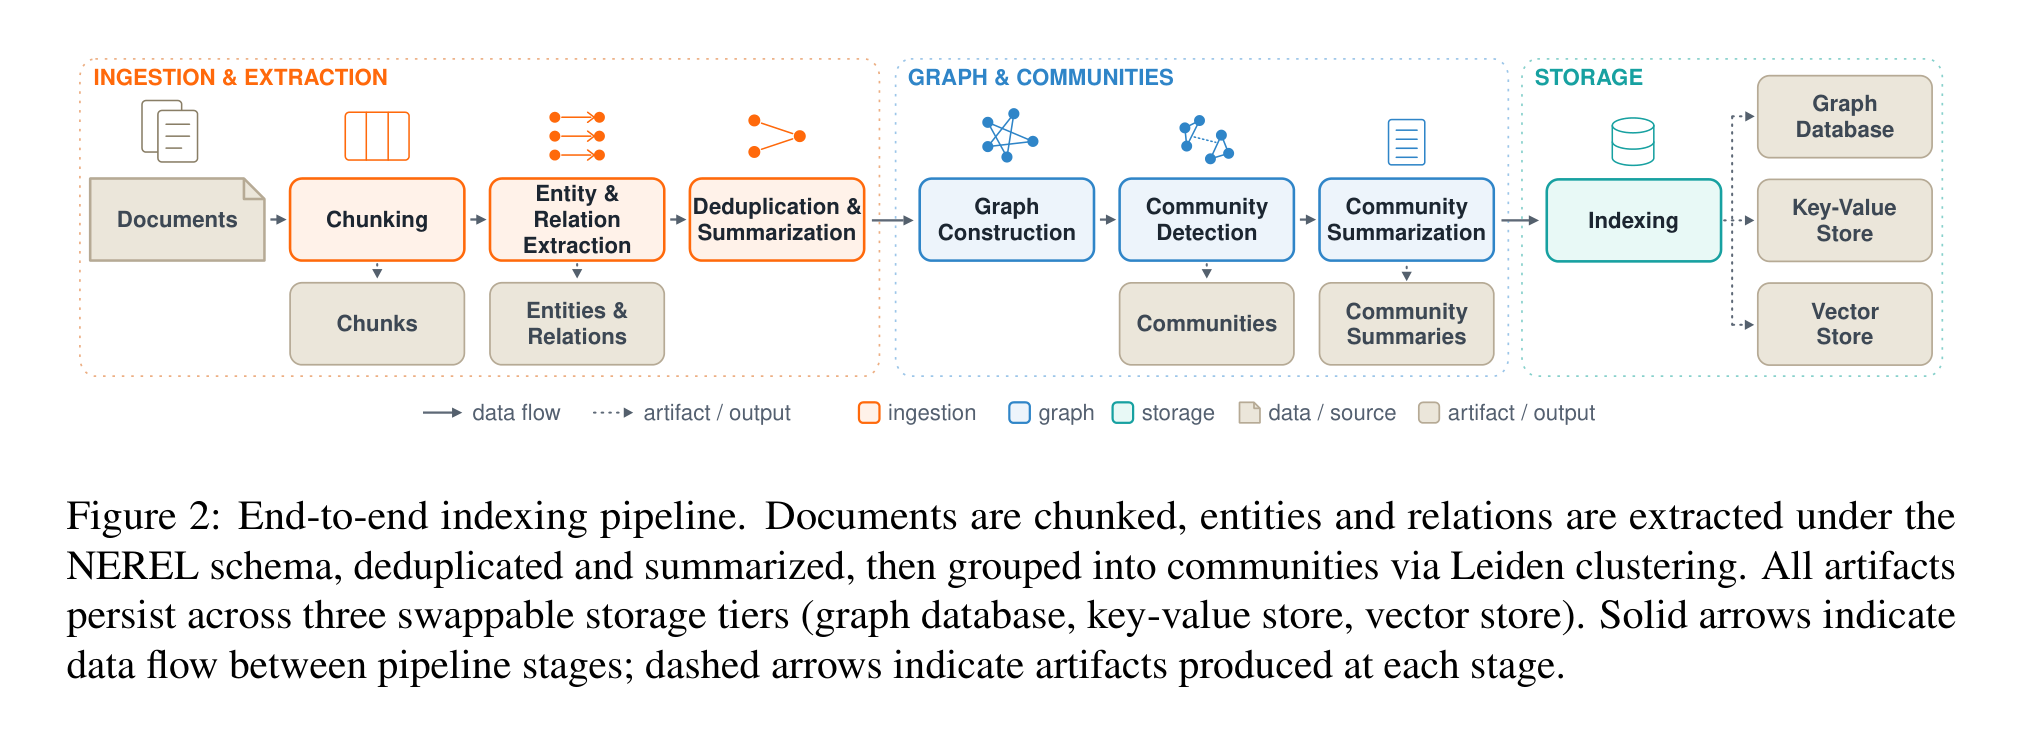
[논문 리뷰] RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM
단일 패스 추출 대신 추출과 통합을 분리한 GraphRAG 엔진, 그리고 RAG 파이프라인 안의 LLM 에는 세계 지식이 아니라 언어 능력이 필요하다는 가설로 7B 추출기를 정당화한 시스템 논문
-
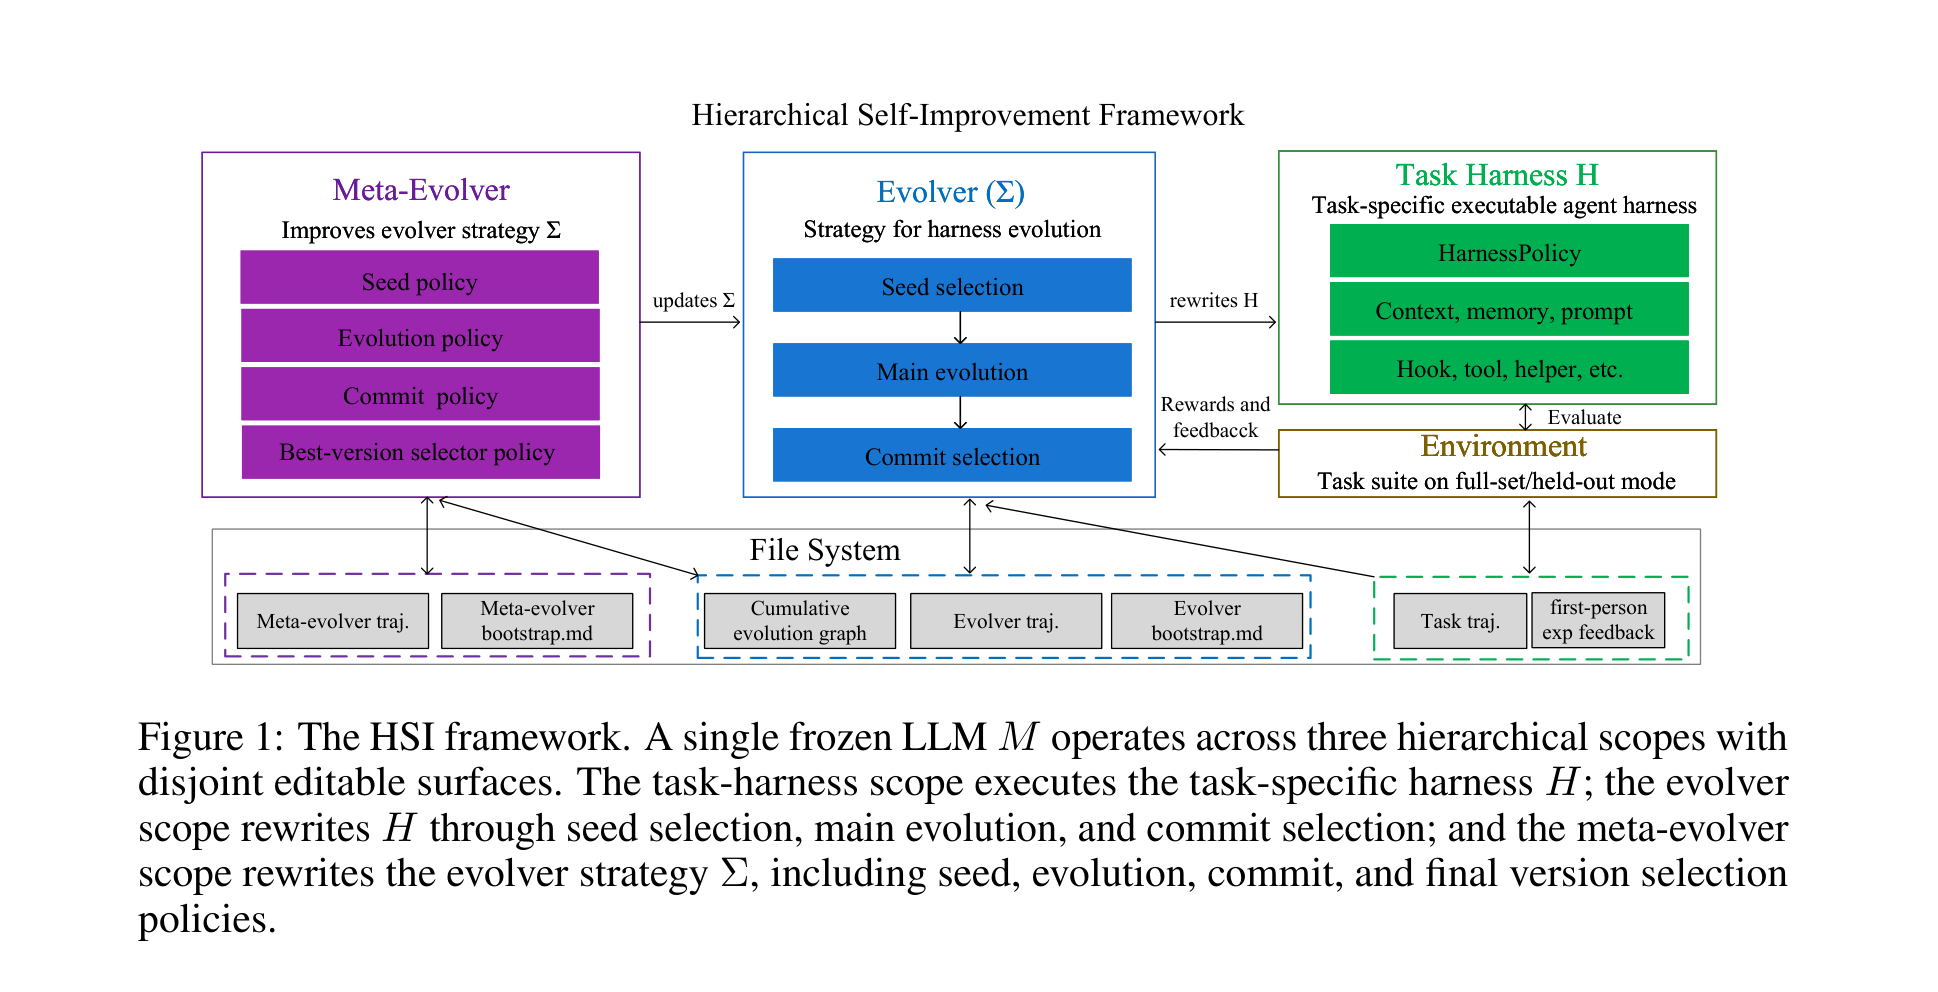
[논문 리뷰] Hierarchical Self-Improvement: A Framework for Task-Specific Evolvable Agent Harnesses
모델을 얼려둔 채 에이전트 하네스만 3계층으로 진화시켜 BALROG 에서 BabyAI +39.3, Crafter +33.0 을 얻고, 그 개선이 어디서 멈추는지까지 실증한 프레임워크
-
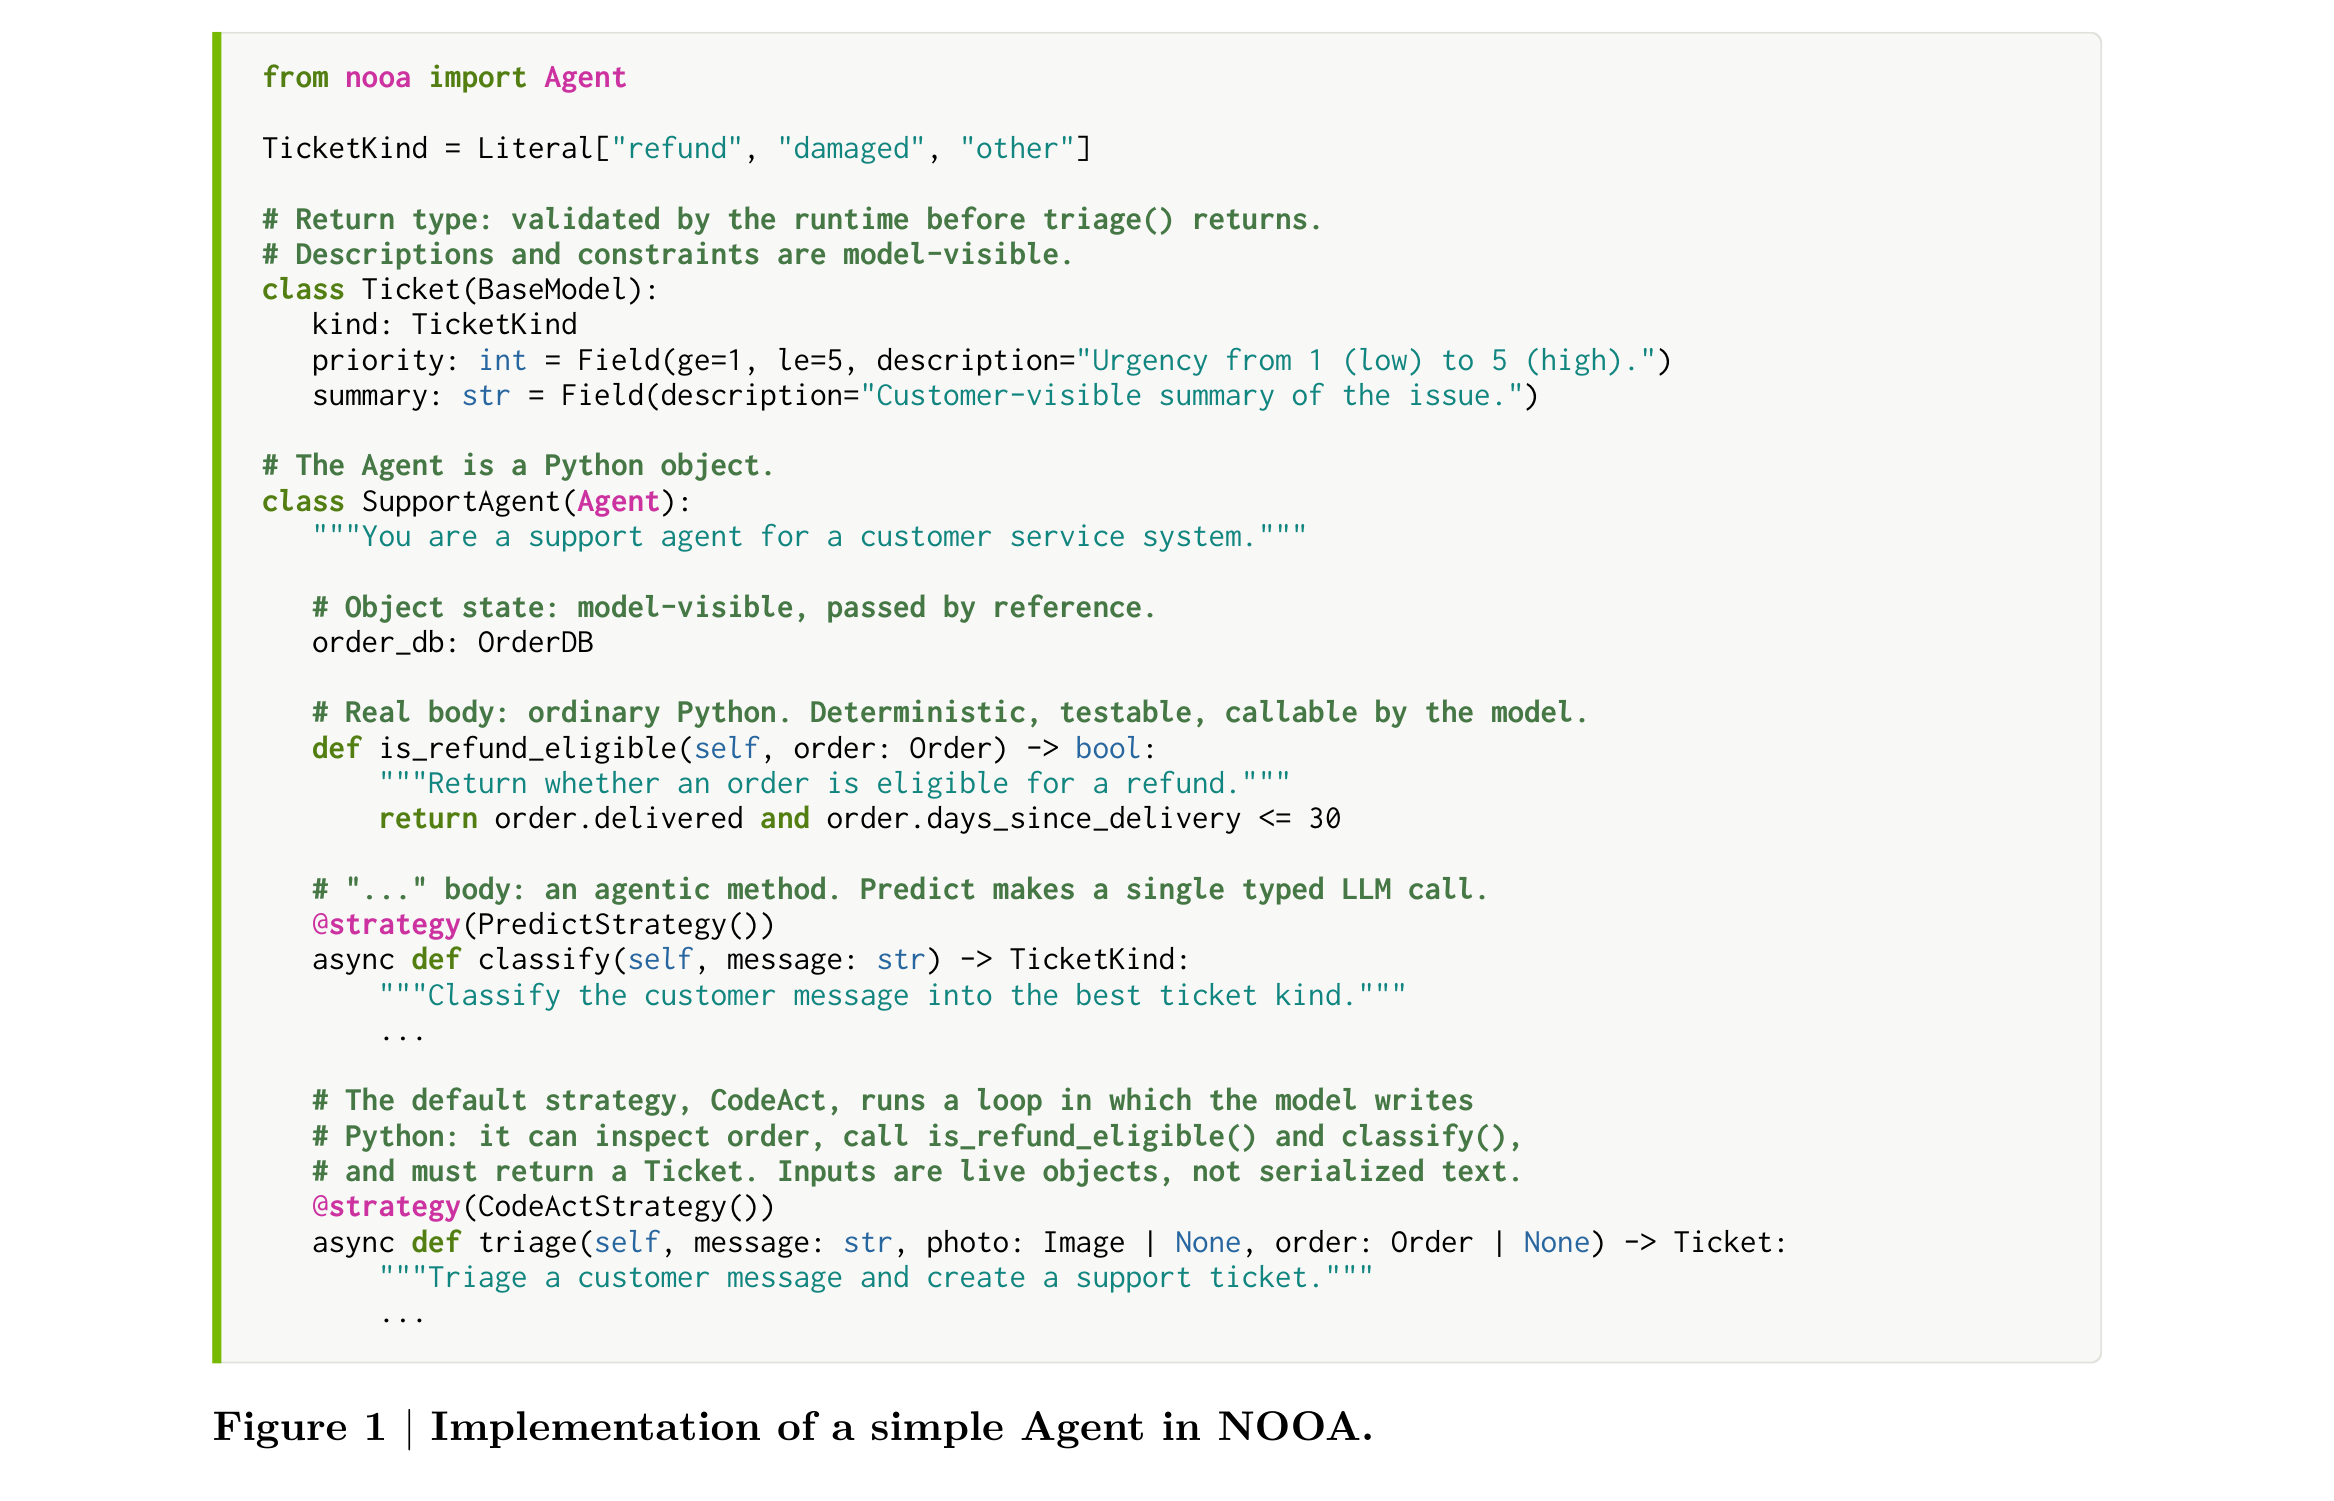
[논문 리뷰] NVIDIA-labs OO Agents: Native Python Object-Oriented Agents
에이전트를 프롬프트 템플릿·툴 스키마·워크플로 그래프의 조합이 아니라 그냥 Python 객체로 만든다. 메서드가 행동, 필드가 상태, docstring 이 프롬프트, 타입 어노테이션이 계약이다.
-
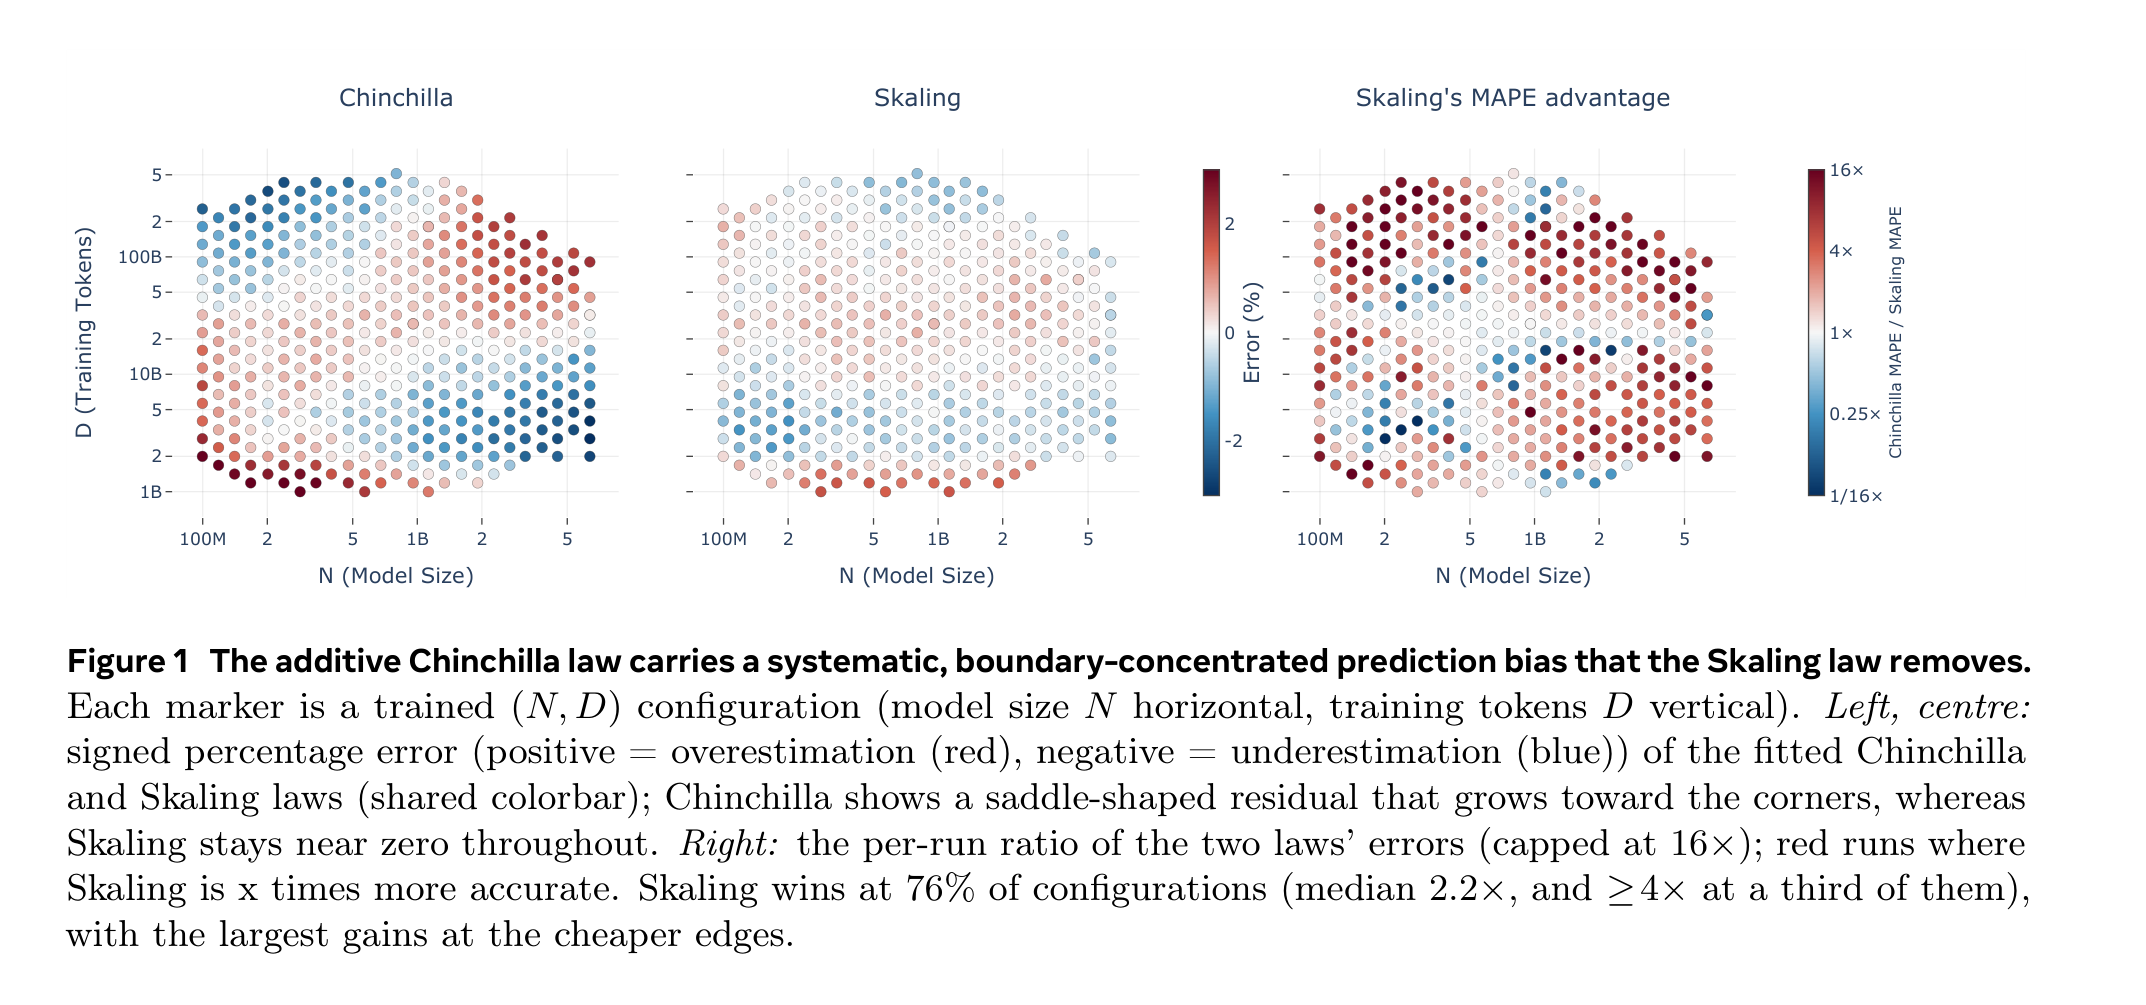
[논문 리뷰] Skaling: Chinchilla's Exponents Meet Kaplan's Coupling
Chinchilla 의 가법형 scaling law 가 강제하는 '모델 크기와 데이터는 독립'이라는 가정을 실측 혼합 편미분으로 반증하고, 외부 지수 하나로 두 축을 결합해 경계 외삽 오차를 10배 넘게 줄인 연구